使用GPU和NI LabVIEW进行测试系统硬件加速
概述
现代测试系统需求高吞吐率处理,GPU凭借强大并行计算能力,为信号处理、图像分析和AI推理等任务提供了理想解决方案。LabVIEW与Ngene、Graiphic及G²CPU等第三方工具包结合使用,实现无陡峭学习曲线的无缝GPU加速。
工程师可通过RADX PXI Express模块、MXI Express扩展或联网GPU服务器,将GPU集成至测试系统,显著提升测试速度和系统可扩展性。借助直观工具和灵活部署,GPU加速现已在NI平台内可用,助力实现更快、更可扩展、更具未来性的测试工作流程。
内容
- 为什么硬件加速对于现代测试系统至关重要?
- 在测试与测量应用中,GPU与FPGA和CPU的对比如何?
- LabVIEW中通过第三方工具包实现GPU加速
- GPU与NI硬件连接
- RADX及NI硬件平台
- 总结与关键要点
为什么硬件加速对于现代测试系统至关重要?
本白皮书探讨了将GPU作为硬件加速器进行战略使用的意义,以应对计算密集型测试应用日益增长的需求。随着各行业越来越依赖高吞吐率处理以提升测试效率,可扩展的高性能计算变得不可或缺。GPU凭借其大规模并行处理能力和数千核心,相比传统CPU具有显著优势,非常适合图像与信号处理、深度学习推理及矩阵计算等任务。
通过将GPU与NI LabVIEW集成并利用兼容的硬件和工具包,能够有效实现GPU加速,并无缝集成至现有测试系统。此方法为工程师和系统架构师提供了直观框架,最大化硬件加速在其工作流程中的应用。选择合适的硬件平台带来处理速度提升、延迟降低、能效改善及未来应用的可扩展性能等诸多优势。
在测试与测量应用中,GPU与FPGA和CPU的对比如何?
GPU因其无与伦比的并行处理能力,在神经网络、图像处理和仿真任务中表现出色。然而,GPU的并行优势仅在大规模任务中显现,因为将任务卸载到GPU需要昂贵的数据传输成本、数据一致性同步和内核启动延迟。GPU不适合处理数据量小且计算操作差异较大的小规模数据集。
FPGA提供可定制架构,适合确定性系统,如嵌入式系统和实时信号处理。它们能提供优化的处理环境和低功耗解决方案,尤其适合电源受限的AI模型。然而,为实现最佳性能,FPGA编程需要较高的开销。
通用处理器一般拥有较少的计算核心,每个核心配有独立控制单元,具备灵活性和控制力。与GPU相比,CPU更加侧重于控制单元,能支持单核上下文切换。
NI模块化平台利用CPU实现灵活性与复杂控制逻辑,利用FGPA实现确定性与精确控制。现在,引入GPU则构成了面向吞吐率加速的第三支柱。
LabVIEW中通过第三方工具包实现GPU加速
LabVIEW提供强大原生功能和丰富内置功能,适用于多种应用;第三方工具包进一步扩展了GPU加速的便捷集成能力。这些工具包界面直观,类似原生LabVIEW,降低了开发者的学习曲线。它们新增专门针对GPU的函数,帮助用户利用GPU性能,无需从零开发所有组件。本节将介绍NI生态系统中三款重要的第三方工具包,这些工具包能够为各类应用实现GPU加速,突显其功能及高效架构,满足高性能需求。
Ngene CuLab工具包
现代工程与科学应用对计算能力需求巨大,尤其在射频信号处理、实时监测分析、科学计算与建模及工业机器视觉领域。GPU凭借其并行优势适合此类任务,但LabVIEW缺少原生GPU加速,给不熟悉CUDA或C++的工程师带来挑战。
Ngene CuLab工具包通过提供与LabVIEW直接集成的高性能GPU加速方案填补了这一缺口。其具有类似LabVIEW的API,使工程师无需复杂编程即可加速计算。CuLab简化集成,提供全面GPU加速函数,并展现出卓越的性能,平均速度达到Python框架(如CuPy)的6倍。
CuLab具备多项核心优势。它与类似LabVIEW的API无缝集成,并在数据处理任务上相比基于CPU的标准LabVIEW实现超100倍1的性能提升。该平台包含150多个GPU加速函数,可高效处理多维数组及所有数值数据类型。
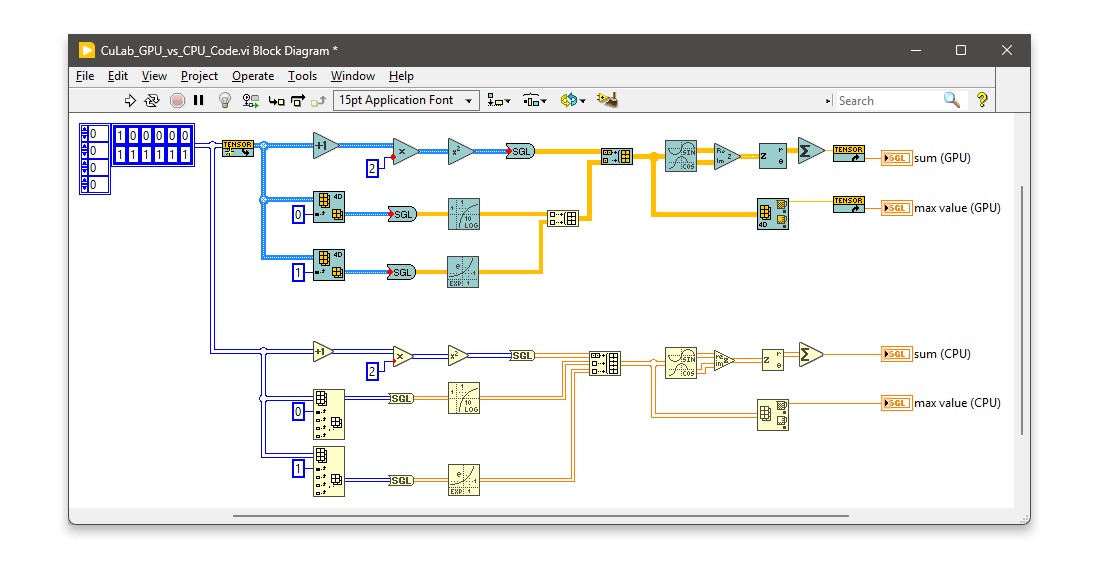
图1.本程序展示原生LabVIEW与CuLab实现的相似性。
CuLab的功能非常全面,与原生LabVIEW高度相似。其函数列表涵盖向量与矩阵运算、线性代数、信号处理、计算机视觉、数学函数及逻辑运算。
Graiphic SOTA工具包
Graiphic推出的LabVIEW SOTA生态系统提供丰富的GPU加速功能,作为PyTorch和TensorFlow等深度学习框架的替代方案。它将LabVIEW转变为通用图形编辑器和编排器,扩展ONNX支持,实现跨硬件的训练与计算。该工具包提供高低层抽象,满足工程师简便部署与研究人员精细控制的需求,覆盖广泛深度学习应用。

图2.加速器选板旨在全面覆盖标准LabVIEW操作的需求。它能够有效管理动态编排,并提供出色的灵活性,以支持不同的执行提供者。公共参考映射了多个后端的节点覆盖范围。
SOTA拥有全面的功能集,可与现有框架相媲美,其加速器工具包将其通用化,扩展了LabVIEW函数选板,使其能够通过ONNX编排计算图。
SOTA生态系统关键组件包括深度学习工具包(训练与推理)、计算机视觉工具包(图像处理)、GenAI工具包(基于变压器模型)及前述加速器工具包。该环境中的工具包擅长计算机视觉、深度学习、GenAI及强化学习,并通过ONNX集成实现了跨硬件平台的性能优化。通过可视化数据流编程实现AI开发大众化,使不具备编程技能的用户也能创建复杂的工作流程。
SOTA优化了异构硬件上的数据标注、AI模型训练、调优和部署。
Natan Biesmans LabVIEW G²CPU高性能计算工具包
G²CPU为LabVIEW提供高性能计算工具包,支持跨CPU、NVIDIA CUDA GPU、OpenCL设备及整个NI生态系统的平台无关代码执行。该工具包基于开源ArrayFire库,简化后端切换,确保长期稳定。
主要优势
- 统一后端抽象——编写一次代码,无需修改即可跨CPU、CUDA及OpenCL部署,提升灵活性。该工具包适用于整个NI生态系统,包括Windows和Linux设备、LabVIEW Real-Time模块、PXI及工业计算机。
- 无缝集成——函数与原生LabVIEW操作高度相似,极大简化集成,降低学习难度。支持调试功能,可通过探针在LabVIEW环境内直接查看不同计算后端的数据。
- 高代码灵活性——即使最复杂算法亦可在GPU上实现,且保持在原生LabVIEW IDE中开发。
- 高性能——对密集任务可达200倍速度提升2,NI PXI GPU I/O速度达7 GB/s,现代系统超22 GB/s。支持NI LabVIEW Real-Time模块中低于1 ms的循环,适用于时间敏感应用。

图3.本示例展示了完全用G²CPU实现的线性拟合算法。可见其与原生LabVIEW的高度相似性。
该软件工具包提供丰富的高性能函数套件,涵盖数学、信号处理、机器视觉、用户界面加速等多领域,可跨GPU类型和操作系统使用。具备高速数据传输能力,可与NI PXI矢量信号收发仪(VST)、支持NI FPGA的硬件及NI帧抓取器等设备无缝集成。基于设备与GPU间高效零拷贝数据传输,G²CPU具备高度灵活性和性能,支持自定义GPU内核及第三方工具包扩展,能无缝集成NVENC、LibTorch、OpenCV等工具包。G²CPU是开发者在任何领域实现卓越性能及自由开发的理想方案。
GPU与NI硬件连接
本节介绍如何连接GPU服务器,以及PXI Express到MXI Express的配置。
通过网络连接GPU服务器
通过网络接口卡(NIC)和智能NIC高效连接GPU服务器,可实现网络性能优化。智能NIC集成CPU和GPU组件,支持高强度计算与并行处理任务。它们智能地卸载网络处理,减少开销,从而提高流向GPU服务器的数据流效率。智能NIC提升网络数据处理能力,支持25 GB/s带宽的分布式计算,更有效利用联网GPU资源。包括NI CompactRIO和NI CompactDAQ系统在内的其他NI硬件,同样可通过以太网或USB连接GPU服务器并加以利用。

图4.PXI机箱通过NIC或智能NIC与外部GPU服务器联网,实现高速加速计算。
PXI Express到MXI Express的配置
PXIe至MXIe的配置适合需要外部GPU功能的设置,尤其适用于高性能计算。连接PXIe机箱与MXIe接口,用户可访问强大外部GPU,从而突破本地硬件限制提升计算能力。该方案适用于空间受限及需跨系统多GPU执行大规模数据处理、AI开发或仿真的场景。Gen 3 x16 MXIe接口支持16 GB/s数据传输速率,减少瓶颈,使高要求应用能够高效利用外部GPU或GPU服务器资源。

图5.PXIe机箱通过MXIe扩展连接GPU服务器,实现高带宽数据传输,支持加速处理与高级计算。
RADX及NI硬件平台
RADX Technologies Inc.提供专为NI生态设计的商用现成PXI Express GPU模块,但产品与NI自有有所区别。基于NVIDIA Turing、Ampere和Ada架构GPU,这些模块可无缝集成至NI PXIe-1092或PXIe-1095机箱,增强测试测量环境的计算能力。RADX PXIe GPU支持多种应用,包括数据采集及机器学习,使用LabVIEW和Python等工具,无需单独的GPU服务器。
RADX Technologies机箱内GPU可提供1.7至30.3 FP32 TFLOPS的计算性能,并配备4GB至24GB显存。但这些配置可能会因GPU之间缺乏点对点通信(Linux除外)而导致数据瓶颈。需要采用零拷贝技术等方法缓解限制,充分发挥GPU能力并缓解瓶颈。RADX GPU经过NI系统认证,常与G²CPU配合用于LabVIEW的GPU加速信号处理。

图6.RADX PXIe兼容GPU模块及相关产品
总结与关键要点
总之,测试工程师因GPU的卓越性能和可编程性,越来越多地采用GPU加速测试。GPU的大规模并行和可扩展计算能力,使其成为信号处理、图像处理、仿真及模型控制等数据密集型应用的理想选择。但由于数据需求,GPU仍仅适用于适合的工作流程。
通过PXI Express支持的合作伙伴GPU与LabVIEW工具包,将GPU加速集成到NI生态系统中,为测试工程师提供了适配现有工作流程的灵活高性能补充方案,从而实现GPU应用大众化。这种在熟悉环境中的集成降低了入门门槛,实现更快原型开发、高效数据吞吐和更佳系统可扩展性。
掌握有效使用GPU的方法可让测试测量机构在设计面向未来的系统时获得竞争优势。认识GPU性能提升、利用合适工具及识别计算密集任务均为关键步骤。
| 应用领域 | GPU优势领域 |
|---|---|
| 射频记录与回放/频谱分析 | 实时、多GHz FFT、多相通道化器及时频图渲染 |
| 高速视觉/基于图像的检测 | 卷积神经网络(CNN)及经典OpenCV滤波器每秒处理数百帧图像 |
| 海量波形分析 | 批量处理数百万个波形,包括滤波、相关性分析或基于深度学习的异常检测 |
表1。在关键应用领域中利用GPU强大算力执行任务
| 特征 | CPU | FPGA | GPU |
|---|---|---|---|
| 目标受众 | 分支密集型、顺序逻辑;操作系统服务;较小规模AI/ML工作负载(数百GFLOPs级别) | 纳秒级延迟;自定义I/O协议 | TeraFLOP/PetaFLOP级并行数学运算;AI/ML工作负载 |
| 确定性 | 10 µs-ms级抖动(抢占式操作系统) | 周期精确执行;确定性硬件级时序 | 中等抖动;在内核启动范围内确定性执行 |
| 开发流程 | C/C++、LabVIEW RT、Python | LabVIEW FPGA、VHDL/Verilog、HLS | CUDA/HIP、LabVIEW GPU工具包、Python (Numba/CuPy) |
| 重定位成本 | 无 | 高(综合,时序闭合) | 低(秒级内核重新编译) |
| 测试与测量中的典型用途 | 序列控制、主机用户界面、数据记录 | 精确定时、自定义触发、内联滤波 | FFT、时频图、深度学习推理、大型矩阵运算 |
表2. 选择合适的处理引擎:CPU、GPU或FPGA?
Windows是Microsoft公司的商标。注册商标Linux®的使用获得了Linus Torvalds专属授权商LMI的再授权,Linus Torvalds拥有Linux®注册商标在全球范围内的所有权。