モデルベースシステムに対する信頼の構築
概要
過去40年間、コンピュータの進化は製品のテスト方法を含めたデジタルプロセスを革新する約束を一貫して持ち続けてきました。今日、コンピュータ処理能力、サイバーセキュリティ、人工知能、CADツール、科学に基づくモデルの進歩がその約束を現実に近づけています。設計モデル、それらに対する信頼、テストとシミュレーションを用いて信頼を高める方法の関係を探ってみましょう。
内容
デジタルモデルと物理的テスト
従来、テスト段階は開発の一段階から次の段階へ進むための評価点として機能してきました。たとえば、プロトタイプは設計基準に基づいてテストされ、基準を満たすと設計が次の段階に進みます。しかし、テストデータ自体は設計と共に引き継がれません。設計テストの目的は、プロトタイプ段階の完了を確実にすることだけです。このパターンは、市場調査や概念開発から生産および保守テストまで、すべての設計段階で繰り返されます。その結果、製品開発の過程で貴重なテストデータが残され、多くの学習機会が失われます。
さらに、多くの企業は、従来の順次的な設計手法からより柔軟かつアジャイルな製品開発アプローチへと移行しています。従来の線形的で孤立した開発プロセスは進化しました。その結果、テストは各開発段階に浸透する継続的かつ持続的なプロセスとなっています。
アジャイル開発の採用とデータや知見の共有の必要性により、情報を効果的に収集し開発プロセス全体で共有する方法という重要な問いに注目が集まっています。
データを保存および送信すること自体は本質的に困難ではありません。しかし、そのデータを効果的に管理することは、エンジニアリングチームが長年取り組んできた課題です。最新の情報がデータに反映されていることをどう保証するか?この問いに応えることはデジタルエンジニアリングの根本原則であり、つまり、唯一の信頼できる情報源を確立することです。信頼できる単一の情報源を確立する統制されたデータ管理のアプローチがなければ、チームは確信を持って情報を活用できません。
開発サイクルを通じて、信頼の情報源は適宜進化させる必要があります。テストのたびに新たに得られた情報は既存の知識に統合すべきです。テストを開発プロセスの個々の段階の連続と捉えるのではなく、製品開発を強化する堅牢な知識基盤を築く手段として捉えるべきです。
テストを段階的な手順として捉えることは、テストプロセスを効率良く進める鍵です。この方法は、エンジニアリングチームが次の2つの重要な質問に答える能力に依存しています。
「前段階で得た情報をどのように保存し引き継ぐか?新たなテスト段階で習得すべき情報は何か?」
これらの情報の集積をデジタルスレッドと呼び、開発プロセス全体に情報を伝達します。デジタルスレッドは唯一の信頼できる情報源となり、要件リスト、デジタルモデル、センサの配置、記録テストデータ、モデル化挙動、性能変動、製造時の欠陥、個体差、実使用履歴などのデジタル成果物を含みます。デジタルスレッドは、開発プロセスにおける情報の捕捉と保持に関する最初の問いに答えます。デジタルエンジニアリングプロセスを実装するチームにとって、デジタルスレッドの品質向上が主要な課題となります。
2つ目の問いは新たなテストごとに必要な情報の取得に関するもので、開発プロセスの効率化に寄与します。この問いに対する回答の正確性と完全性が、完成時のデジタルスレッドの品質を左右します。
モジュールで構成されたシステムの誤差には、少なくとも2つの主要因があります。誤差はモジュール間の相互作用から生じ、これらの相互作用が各コンポーネントの動作を変えることによっても生じます。これらの効果をモデル化することは、個々のコンポーネントの動作をモデル化するよりもはるかに難しい場合があります。これらの考慮点は、開発後期のテストエンジニアリングにおける判断指標となります。テストの目的は、単に次の段階へ進むことの判断から、特にシステムを表すモデルにおけるデジタルスレッドへの信頼を確立することに移行しなければなりません。
モデルシステムにおける信頼
異なるモデルは異なる目的を果たします。モデルは概念を視覚的に表現し、正確な機能よりも製品設計の指針となるフィードバック収集を優先するために使われることがあります。モデルは要件の追跡や調達用部品表の作成にも利用できます。モデルは実際のコンポーネントが利用可能になるまでの一時的なプレースホルダとしても機能し、機能性が必須でない場合に用いられます。デジタルモデルは、有限要素解析やセキュリティテストなどのシナリオテストで有効で、モデルの動作と応答が重要となります。最後に、モデルは特定のシリアル番号に紐づくデジタルツインとして活用され、経年劣化する製造時データを取り込み、物理システムの実際の使用状況を模倣します。
これらの用途全体において、物理システムに適合する確度の要求はさまざまです。概念モデルは物理システムの精確な性能を再現できませんが、メンテナンス予測に使うデジタルツインは実使用と故障に即した高い確度が求められます。モデルの確度への信頼度は、そのシステム内でのモデルの信頼性を評価する尺度となります。ここでの信頼性とは、「モデルから得られた情報に基づいて意思決定を行う個人の意欲の程度」を指します。1
モデルの信頼性を高めるには、その信頼性を定量化し進捗を評価する方法が必要です。Eann Pattersonが提唱した枠組みは材料科学を含む複数分野のモデルに適用され、本議論に有用です。このモデルでは、Patterson博士はモデルを2軸で特徴付けることを提案しています。モデルのテスト可能性とモデルの科学的理解度の2軸です。
この枠組みでは、モデルの信頼度はグラフの左下へ近づくにつれて高まります。図1のようにフィールドを4つのセグメントに分けると便利ですが、これらの区分はあいまいな境界であることを理解しておく必要があります。
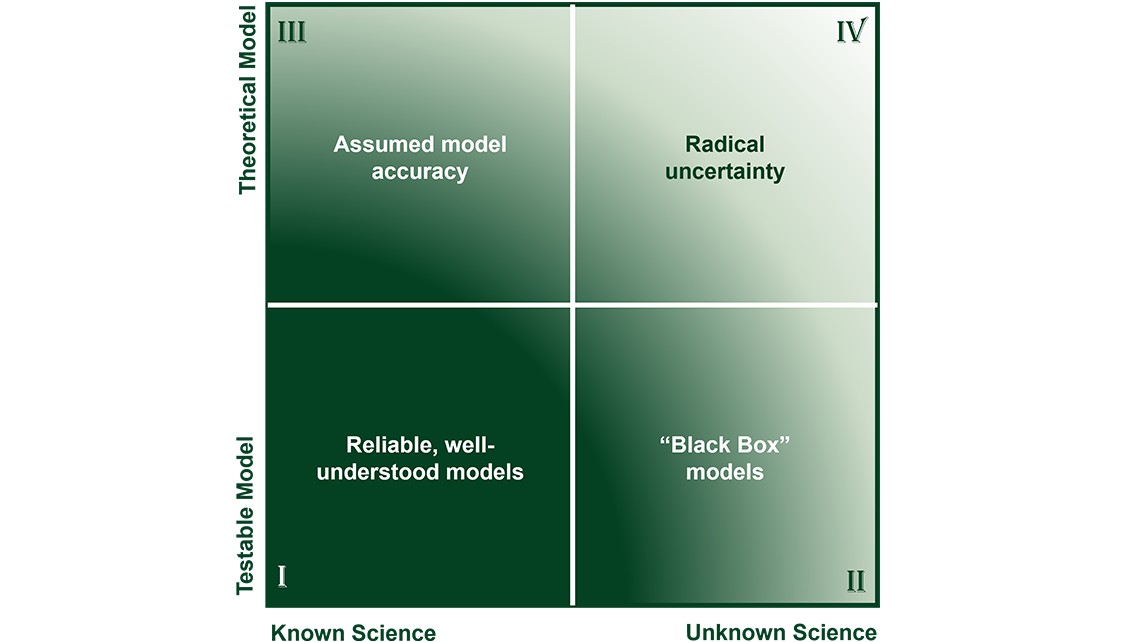
図1. 4つのモデルカテゴリ
これら4つのセグメントは4つのモデルカテゴリに分けられます。エンジニアがモデルの位置づけを理解することはモデルの信頼性に不可欠です。以下に各カテゴリの概略を示します。
I. 既知の科学に基づき検証可能なモデル—このカテゴリでは、エンジニアは多様なツールと指標を用いて適切なモデルの適用を保証します。このカテゴリの例には、機械的なレバー、材料サンプル、理想的な物理問題が含まれます。
II. 実験結果と良く合致する簡易モデル—このケースでは科学的理解が十分でなくても、現象を正確にモデル化するための十分なデータがあります。エンジニアは経験データと照合しながらこれらのモデルを慎重に利用すべきです。たとえば、ダークマターのモデルでは科学的理解は不十分ですが、宇宙ミッションの指針として十分な確度があります。
III. 確固たる科学的基盤があるが検証不可能なモデル—これらのモデルは実験で確度検証ができなくとも、認識的価値により実用的に適用されます。このカテゴリの例には極限熱音響疲労を受けるコンポーネントなどがあります。
IV. 構築とテストが困難なモデル—この領域のモデルは既知の科学にやや基づくものの、基礎科学情報や検証手段へのアクセスがありません。ブラックホールにおける相互作用はこのカテゴリに該当します。
この枠組みはモデルの信頼度判定に役立ちます。次節では、これがエンジニアリングチームのモデルへの信頼向上にどう寄与するかを論じます。
信頼度の向上
これらカテゴリを識別したうえで、信頼度の高い左下方にモデルを導く戦略を検討します。
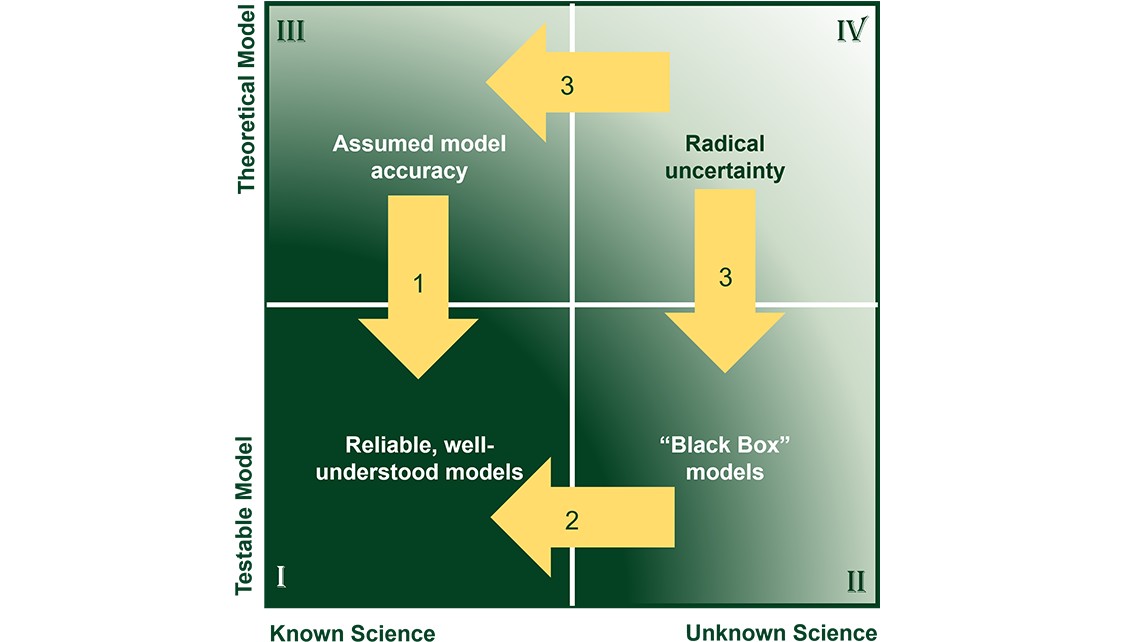
図2.モデルの信頼度を高めるための戦略
図2に示すように、最初の戦略は優れたテスト技術および技術の開発です。測定システムは正確さ、精密さ、速度、解析技術の向上により毎年発展しています。これら技術の進歩によりモデルは左上 (第III象限) から左下 (第I象限) へ移行します。測定企業としてNIはこの戦略に注力しており、以前は難しかった測定の実現を目指しています。
信頼度の低い左上のモデルに直面した際、エンジニアはこれまで困難だった測定手法に資源を集中させられます。特定のモデル問題に関してNIなどの測定会社と業界提携することで、最も関連性の高い問題に重点を置いた測定アプローチを実現できます。
2つ目の戦略は、新たな科学的知見をモデルに取り込むことです。この戦略はブラックボックスに代わる科学的根拠に基づくモデルの開発を目指します。この分野では、NIはAnsysなどの企業と提携して、公開されている科学的原理に基づいた物理シミュレーションを開発し、それを実験データで検証しています。これら詳細モデルから生成される低次数モデル (ROM) は、システムシミュレーション、センサ最適化による計測器改良、仮想センサでの物理測定補強、故障確率解析に使われます。物理モデルと実験データの融合により、システムの不確実性を定量化し、未モデル化の物理現象を捉えるハイブリッドモデルの構築や確率解析による故障検出が可能になります。
3つ目の戦略は、科学的理解が乏しく正確なテストが難しいシステム部分 (第IV象限) に適用されます。これらシステムには、現象の計測や基礎物理の理解のための新しい研究アプローチが必要です。NIは世界中の学術研究プログラムと提携して、これらの概念の理解と計測力向上に努めています。