効率的なデータ移動とスループットのためのPXI Expressシャーシの選択
概要
テストシステムが複雑化し、データスループットの需要が増加すると、システム設計者はテストシステムのすべての部分が信頼性の高い高速データ移動を維持できるようにするという課題に直面します。
このホワイトペーパーでは、PXI Express (PXIe) アーキテクチャの概要、PXIシャーシ設計と帯域幅仕様がシステム全体のパフォーマンスに与える影響、およびボトルネックを回避するための帯域幅に基づいたシャーシ選択に関する実用的なガイダンスについて説明します。これらの原則を理解することで、エンジニアはスケーラブルなパフォーマンスを提供し、データの整合性を維持し、将来のアプリケーション拡張をサポートする自動テストシステムを設計できます。
内容
背景:高速/低遅延通信の必要性
テストおよび測定システムを構築する際に考慮すべき重要な要素は、データがシステム内をどれだけ高速で確実に移動できるかです。計画が甘いと、測定の見過ごし、テストスループットの低下、またはプロジェクトの後半で予期しないコストのかかる再設計が発生する可能性があります。
PXIシステムは、PCI Express (PCIe) テクノロジーを使用してシャーシのバックプレーンにデータ移動を統合し、高速で低遅延の通信を可能にするため、他のシステムと一線を画しています。これにより、図1に示すように、PXIはLAN、USB、またはGPIBを使用して接続されたスタンドアロン計測器と比較して、複雑で大量のデータを処理するアプリケーションに特に適しています。

図1:メインストリームT&Mバスの理論上の帯域幅とレイテンシ
帯域幅に関する注意事項
システム設計者にとって、シャーシ帯域幅は全体的なパフォーマンスと拡張性に影響する定義要件です。PXI Expressシステムのほとんどのデータはシャーシを通過するため、現在の要求を満たし、将来の拡張にも対応できるシステムを選択することは、システム設計において最も影響の大きい決定の1つです。
すべてのPXI Expressシャーシは、PCI Expressインタフェースを使用してシステムコントローラと各スロットのPXIモジュール間でデータを転送します。 このインタフェースは、生成とレーン幅の2つの主な仕様で定義される、各モジュールとの間でデータをどれだけ速く移動できるかを決定します。
このインタフェースがシステムの帯域幅をどのように定義するかを理解するには、図2に示す以下の重要な概念を理解することが重要です。
- スロットあたりの帯域幅―PCI Expressの世代とスロットのレーン幅によって決定される、各モジュールとPXIシャーシバックプレーン間の最大データ転送レート。
- PXIeセグメント―データトラフィックを分散し、シャーシとコントローラ間の帯域幅のボトルネックを防止する、専用のPCI Expressスイッチによって管理されるPXIスロットのグループ。
- 最大システム帯域幅―すべてのモジュールまたはセグメントとシステムコントローラ間で同時にデータを転送するシャーシバックプレーンの合計データスループット容量。
- リンク速度―データの移動速度を定義するシステムの2つの要素間のPCI Expressインタフェース接続のデータレート。
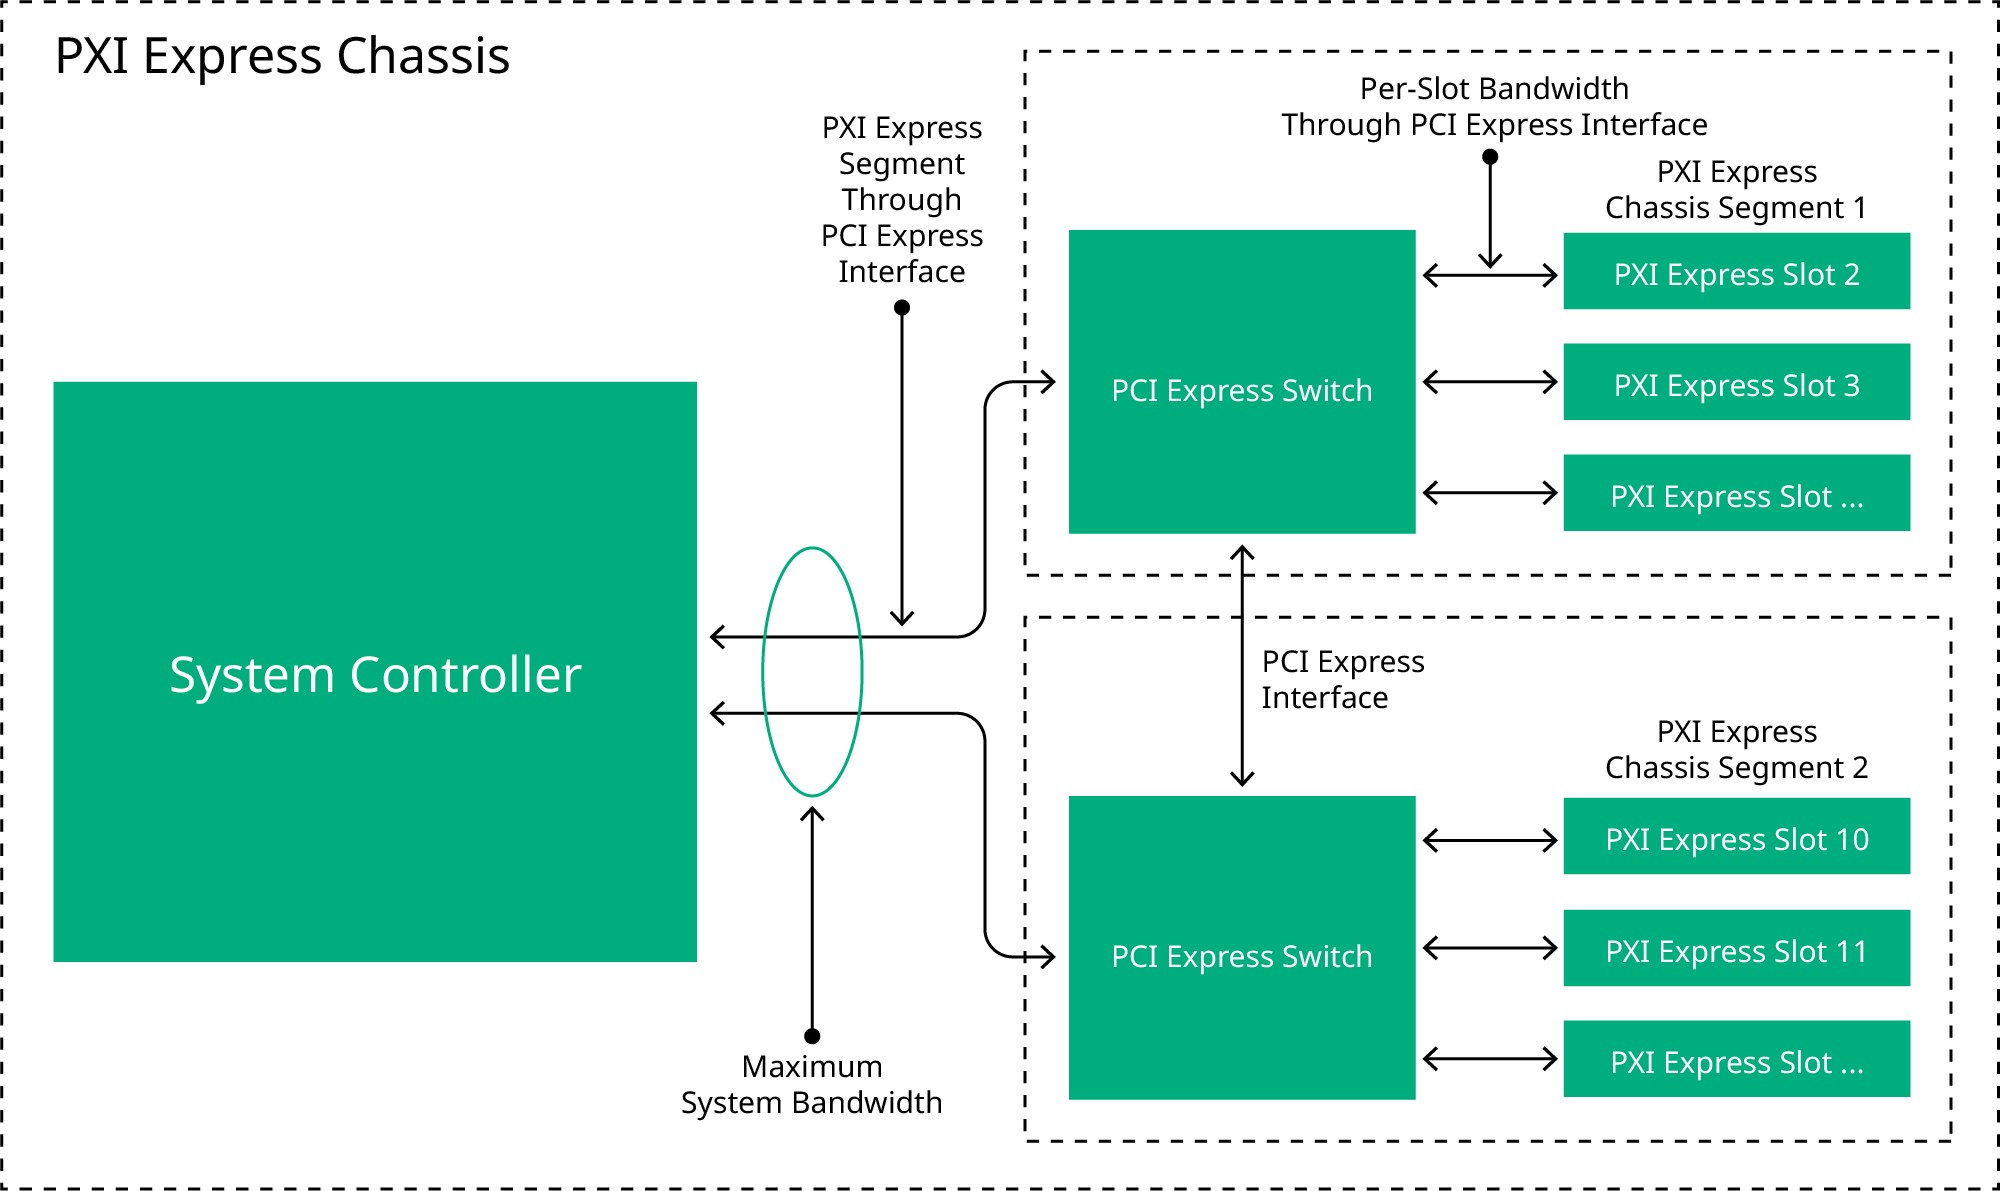
図2:PXI Expressバックプレーンアーキテクチャ: スロット単位、セグメント、およびシステム帯域幅
PXIシャーシの帯域幅がパフォーマンスに与える影響を完全に把握するために、次のセクションではモジュールからコントローラへのデータパスを追跡し、経路の各段階とバックプレーンがどのように高速通信を促進するかを説明します。この観点は、帯域幅が重要な理由と、帯域幅がシステム全体の効率に与える影響を示します。
スロットあたりの帯域幅
スロットあたりの帯域幅は、1つのモジュールがPCI Express接続を介して転送できるデータ量を定義します。表1に示すように、シャーシ設計により、スロットあたりの帯域幅は各方向で250 MB/s~8 GB/s入力の範囲になります。
表1: NI PXIeシャーシの最大スロットあたり帯域幅 (生成およびレーン幅に基づく)
メモ: 表示されている値は、PCI Expressの理論上の最大スロットあたり帯域幅を表しています。実際には、Gen 1およびGen 2はエンコードオーバーヘッドのため、通常レーンあたり約200 MB/sを維持しますが、Gen 3は定格制限に近い値で動作します。
しかし、ほとんどのテストシステムでは、複数のモジュール (ストリーミングデータ) を同時に使用する必要があります。この場合、全体的なスループットは個々のスロット性能によってのみ制限されるものではなく、シャーシのバックプレーン全体の帯域幅によっても制限されます。
さまざまな計測器タイプの標準データレートを理解することで、帯域幅の集約が重要な理由がわかります。モジュールが一緒に動作する場合、それらの組み合わせたデータフローは、バックプレーンの容量にすぐに近づくか、それを超える可能性があります。 表2は、一般的な計測器データレートの基準を示しています。
表2: モジュールあたりの帯域幅
古いハイブリッド互換のPXIモジュールは、PCI Expressではなく元のパラレルPCIバスで動作することに注意してください。このバスの理論上の限界は132 MB/sですが、PCIは共有バスであるため、シャーシの種類に関係なく、持続的なスループットは通常100~110 MB/s程度になります。同じPXIセグメント上のすべてのモジュールがその帯域幅を共有します。
通常、スロット数が多いPXI Expressシャーシでは、PCI Expressバックプレーンを複数のセグメントに分割し、それぞれが独自のPCI Expressスイッチで管理します。このマルチセグメントアーキテクチャは、図 3に示すようにPCI Expressレーンを別々のスイッチに分散することで、全体的なデータスループットを向上させます。
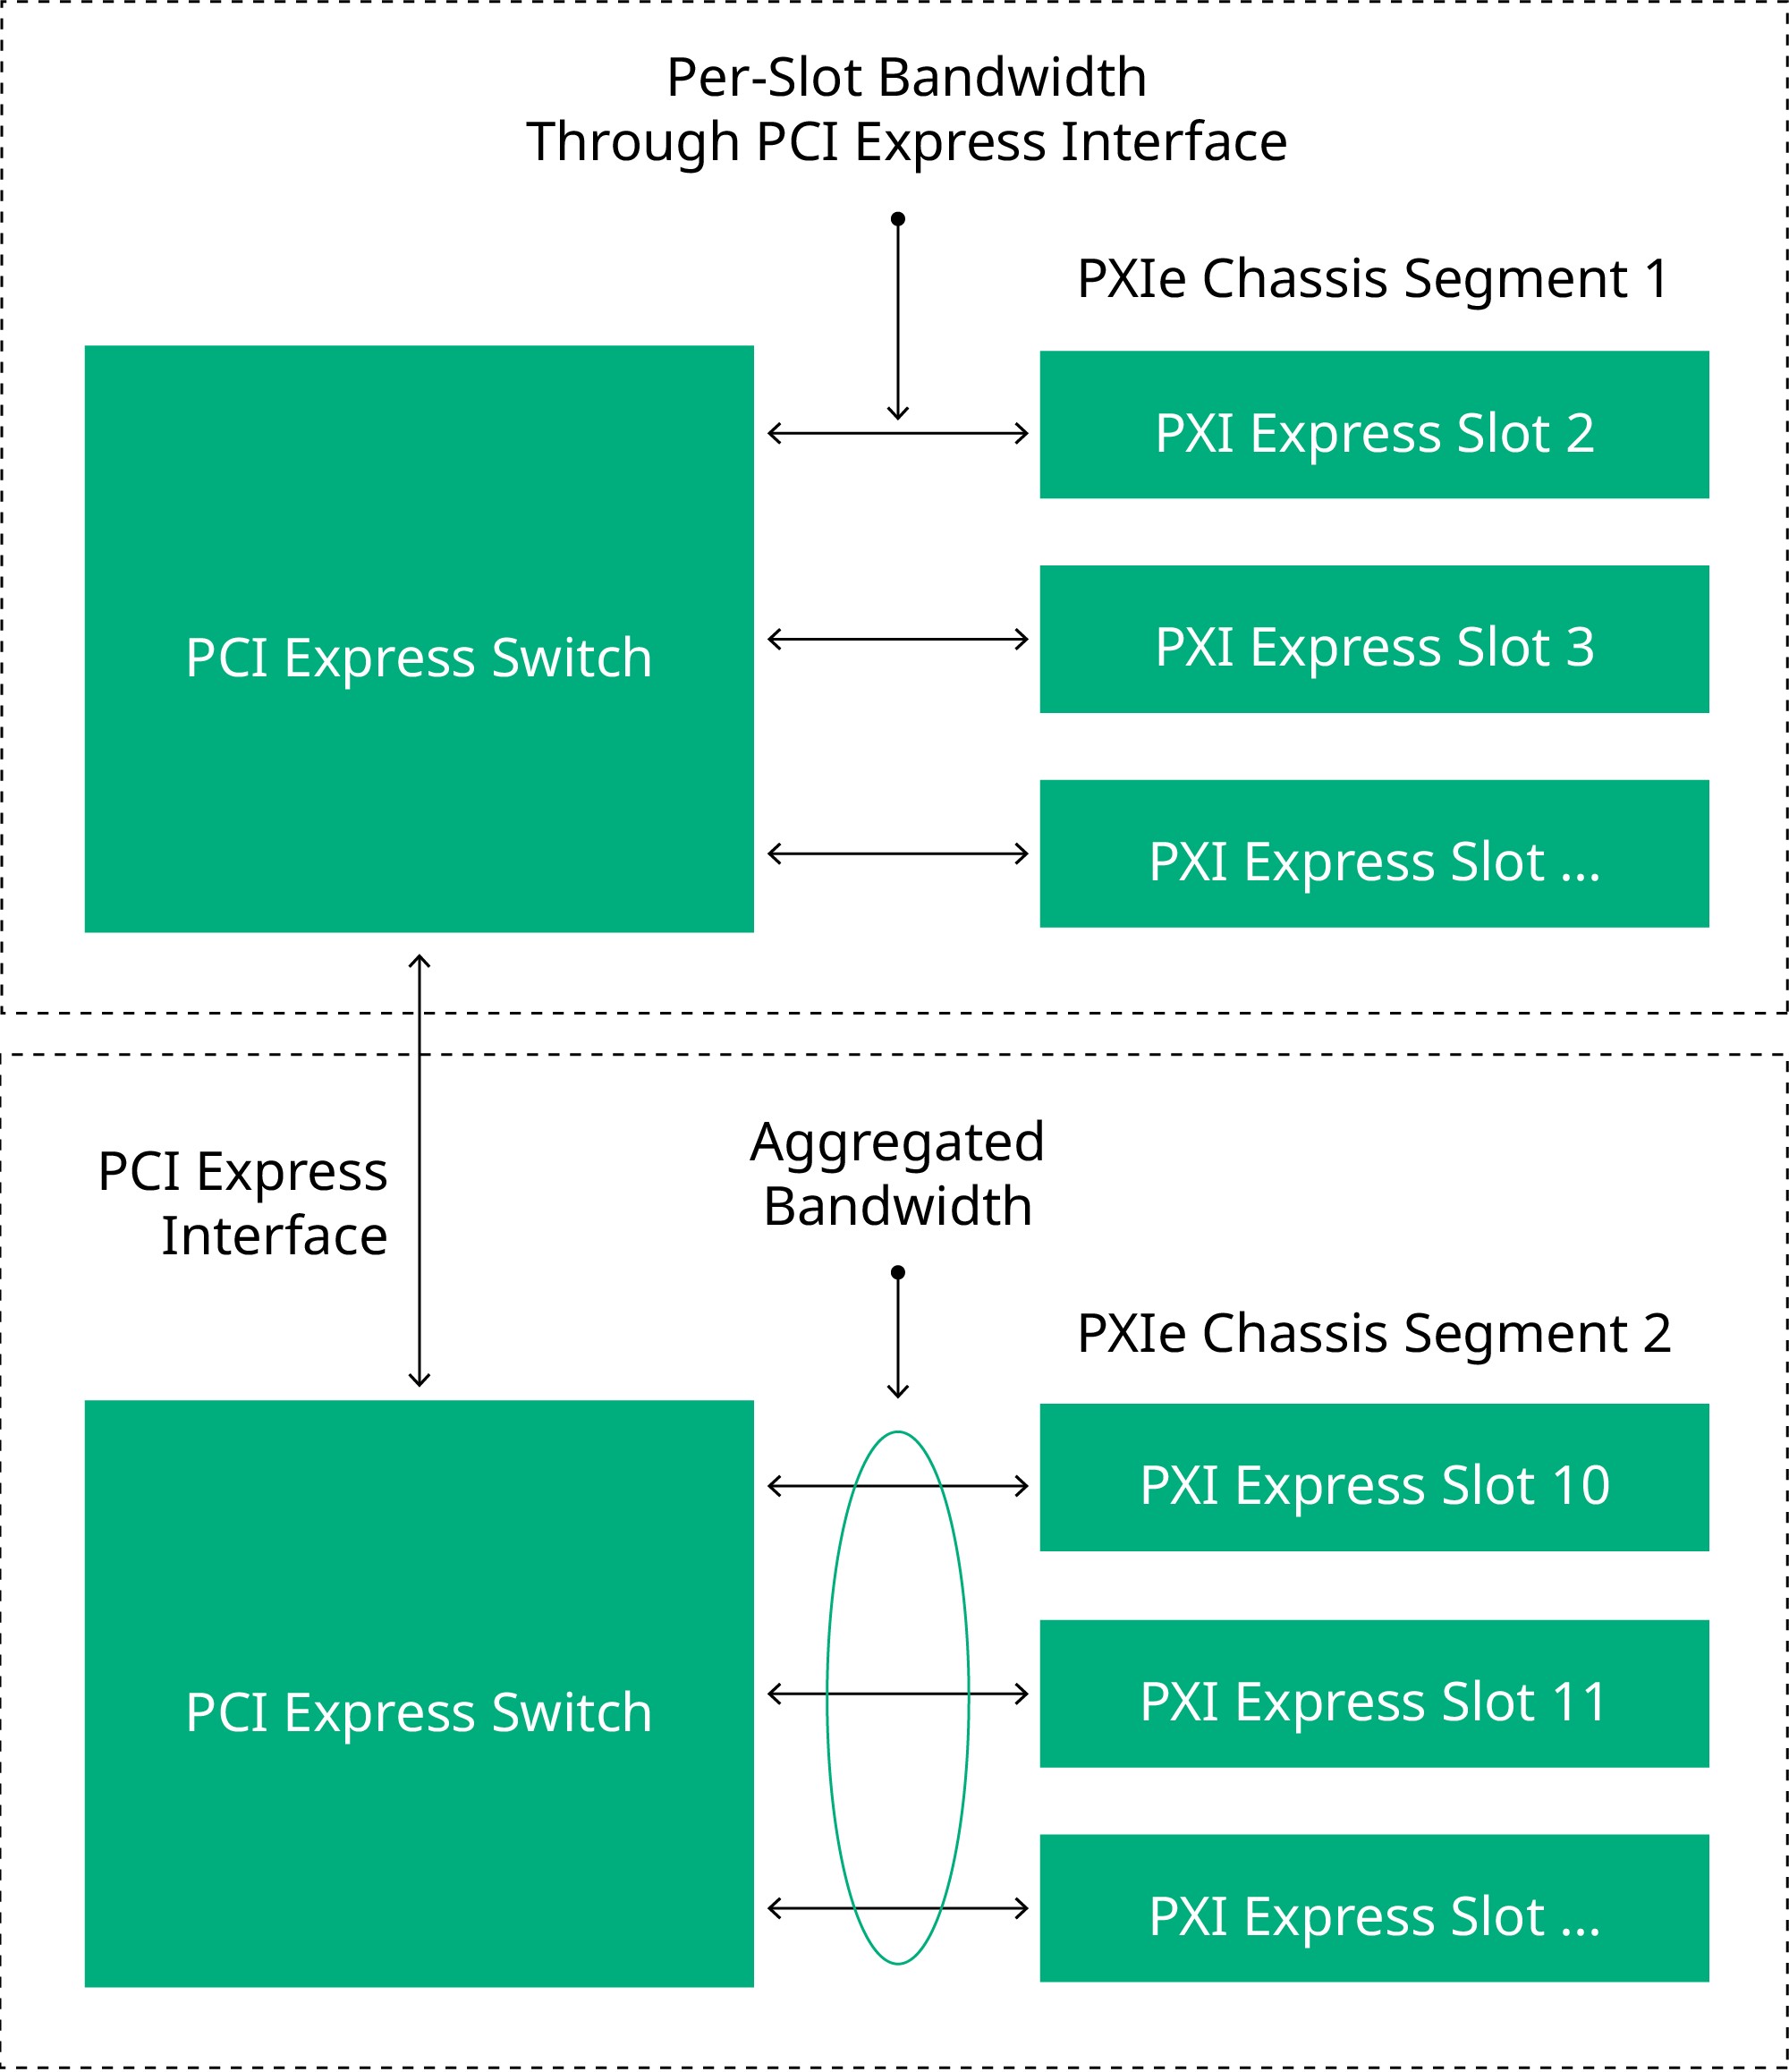
図3:PXI Expressバックプレーンアーキテクチャ: スロット単位、集約、セグメント間帯域幅
NI Peer-to-Peer (NI-P2P) ドライバは、システムコントローラスロットへの帯域幅のアップなど、セグメント外のシステムリソースに負荷をかけることなく、単一セグメント内のサポートされているデバイス間で高速データパスを作成できます。 詳細については、以下の「ピアツーピア」セクションを参照してください。
これらのセグメントがどのように帯域幅を共有して割り当てるかを理解することは、より多くの計測器が並列動作する際に高速ストリーミングとスケーラブルなパフォーマンスを維持するシステムを設計する上で不可欠です。
システム帯域幅
スロットあたりの帯域幅に加えて、PXI Expressシャーシのもう1つの主な仕様は、最大システム帯域幅です。この仕様は、シャーシからシステムコントローラに接続されているすべてのPCI Expressレーンの合計と、それらのレーン間のデータ移動速度を示します。
この情報はいくつかの方法で検索できます。
- 必要なシステム帯域幅が分かっているが、どのPXIシャーシモデルが最適か不明な場合は、PXIシャーシカテゴリページおよび「最大システム帯域幅でフィルタ処理」を参照してください。フィルタ処理された結果の例は、図4に記載されています。
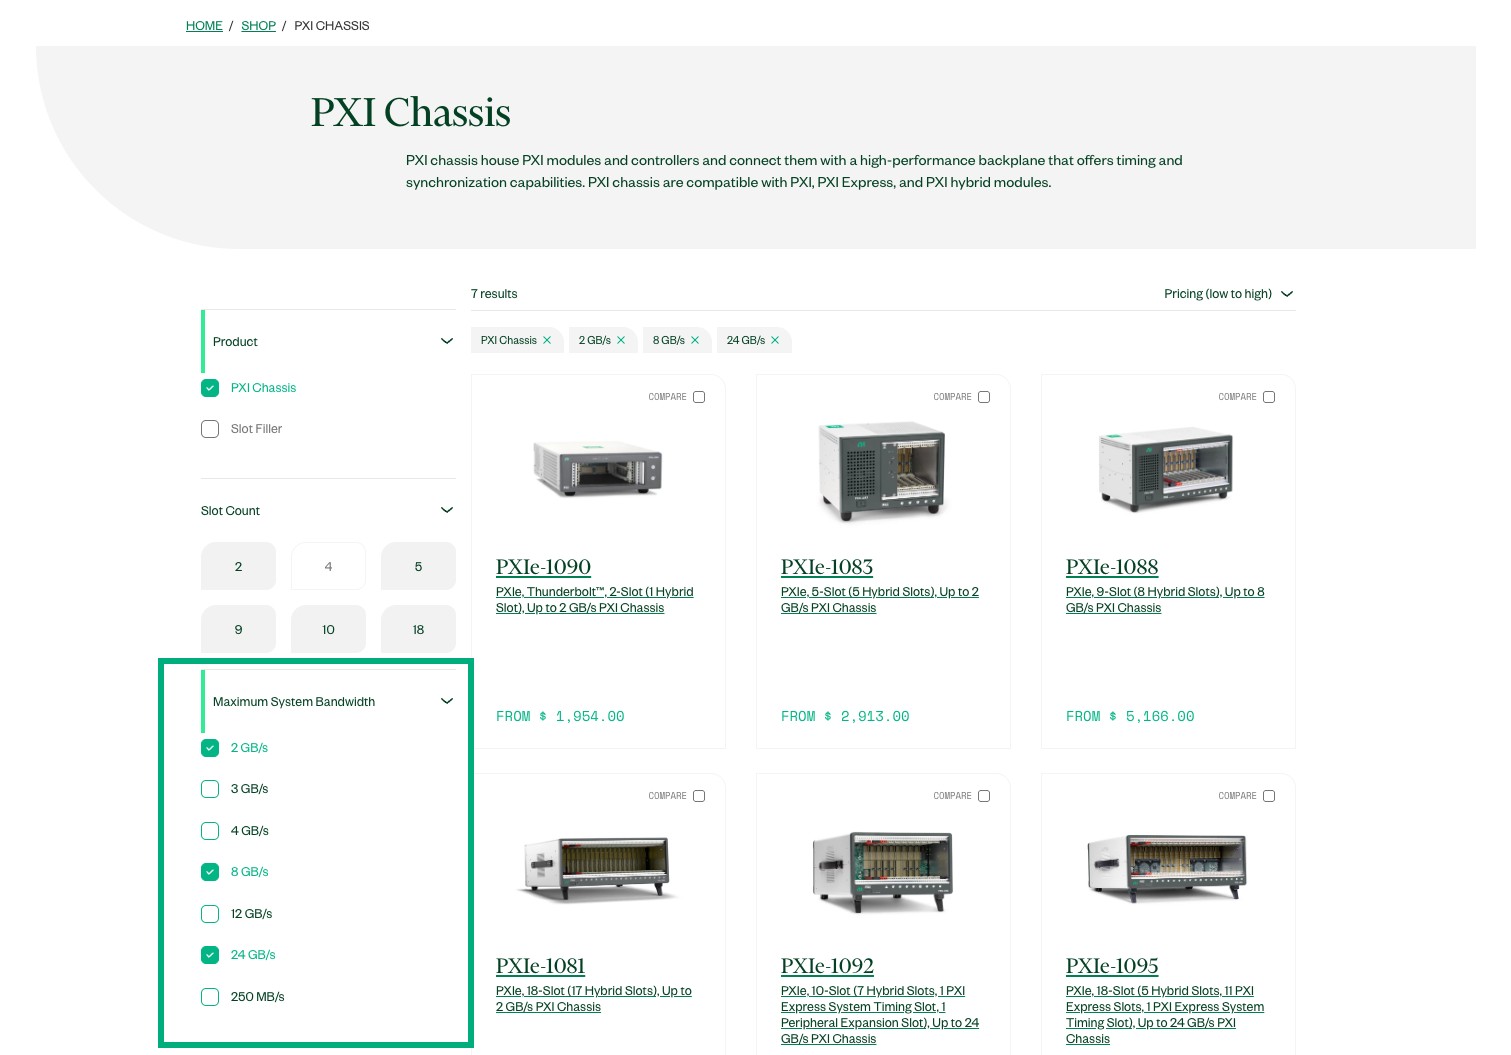
図4:最大システム帯域幅でフィルタ処理されたPXIシャーシポートフォリオ
- 使用しているNI PXI Expressシャーシの型番が分かっているが、その最大システム帯域幅が不明な場合は、製品ページを参照してください。図5に例を示します。
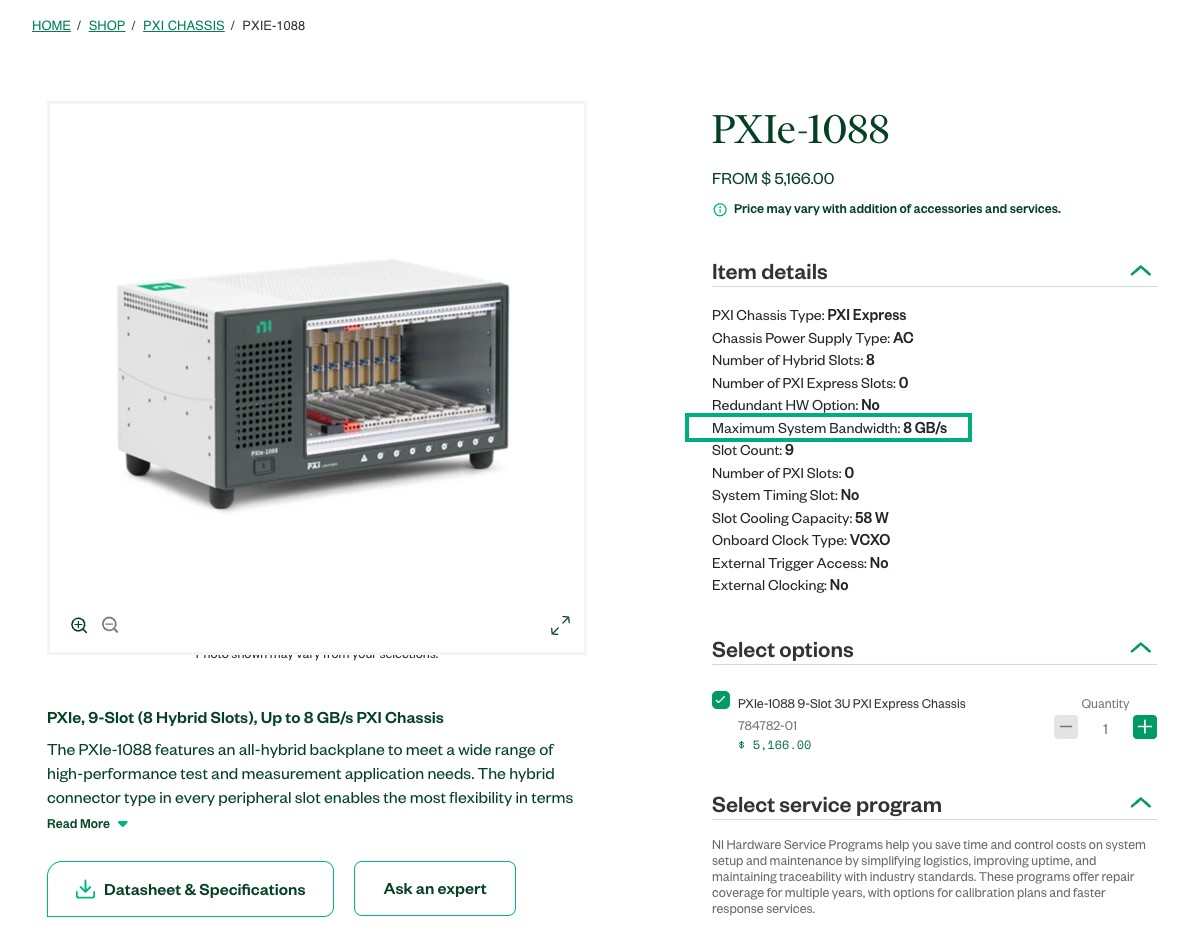
図5: NI PXIe-1088の製品ページ
比較のためにPXIシャーシのポートフォリオ全体を確認する場合は、「PXIシャーシのパンフレット」を参照することを推奨します。
コントローラ帯域幅への影響
シャーシ内の計測器とバックプレーン間でデータをやり取りする場合、システムコントローラスロットがボトルネックになる可能性があります。これは、最大システム帯域幅が、ホストPCに入出力できるデータ量の上限を設定するために発生します。ホストPCは、ホストメモリがあり、したがってシステムのアプリケーションソフトウェアが実行されている場所です。シャーシは、個々のI/Oモジュールとバックプレーンを介してストリーミングされるデータ量に適しているだけでなく、ピーク時のすべての計測器からシステムコントローラスロット (通常はPXI Expressコントローラ、またはMXI Expressを使用して通信するリモートコントローラ) を介して往復する合計データ量にも適合している必要があります。
図 6に示すように、システムコントローラは、アプリケーションコードが一般的に実行するホストメモリにデータを入出力するための重要な要素でもあります。したがって、PXI ExpressコントローラとPXI Expressシャーシに同様の選択基準を適用することを推奨します。慎重に計画することで、必要な帯域幅があらゆる場所で確保されます。 アプリケーションに適したコントローラを選択する方法については、「PXIシステムパフォーマンスの最大化:適切なPXI組込コントローラの選択方法」を参照してください。
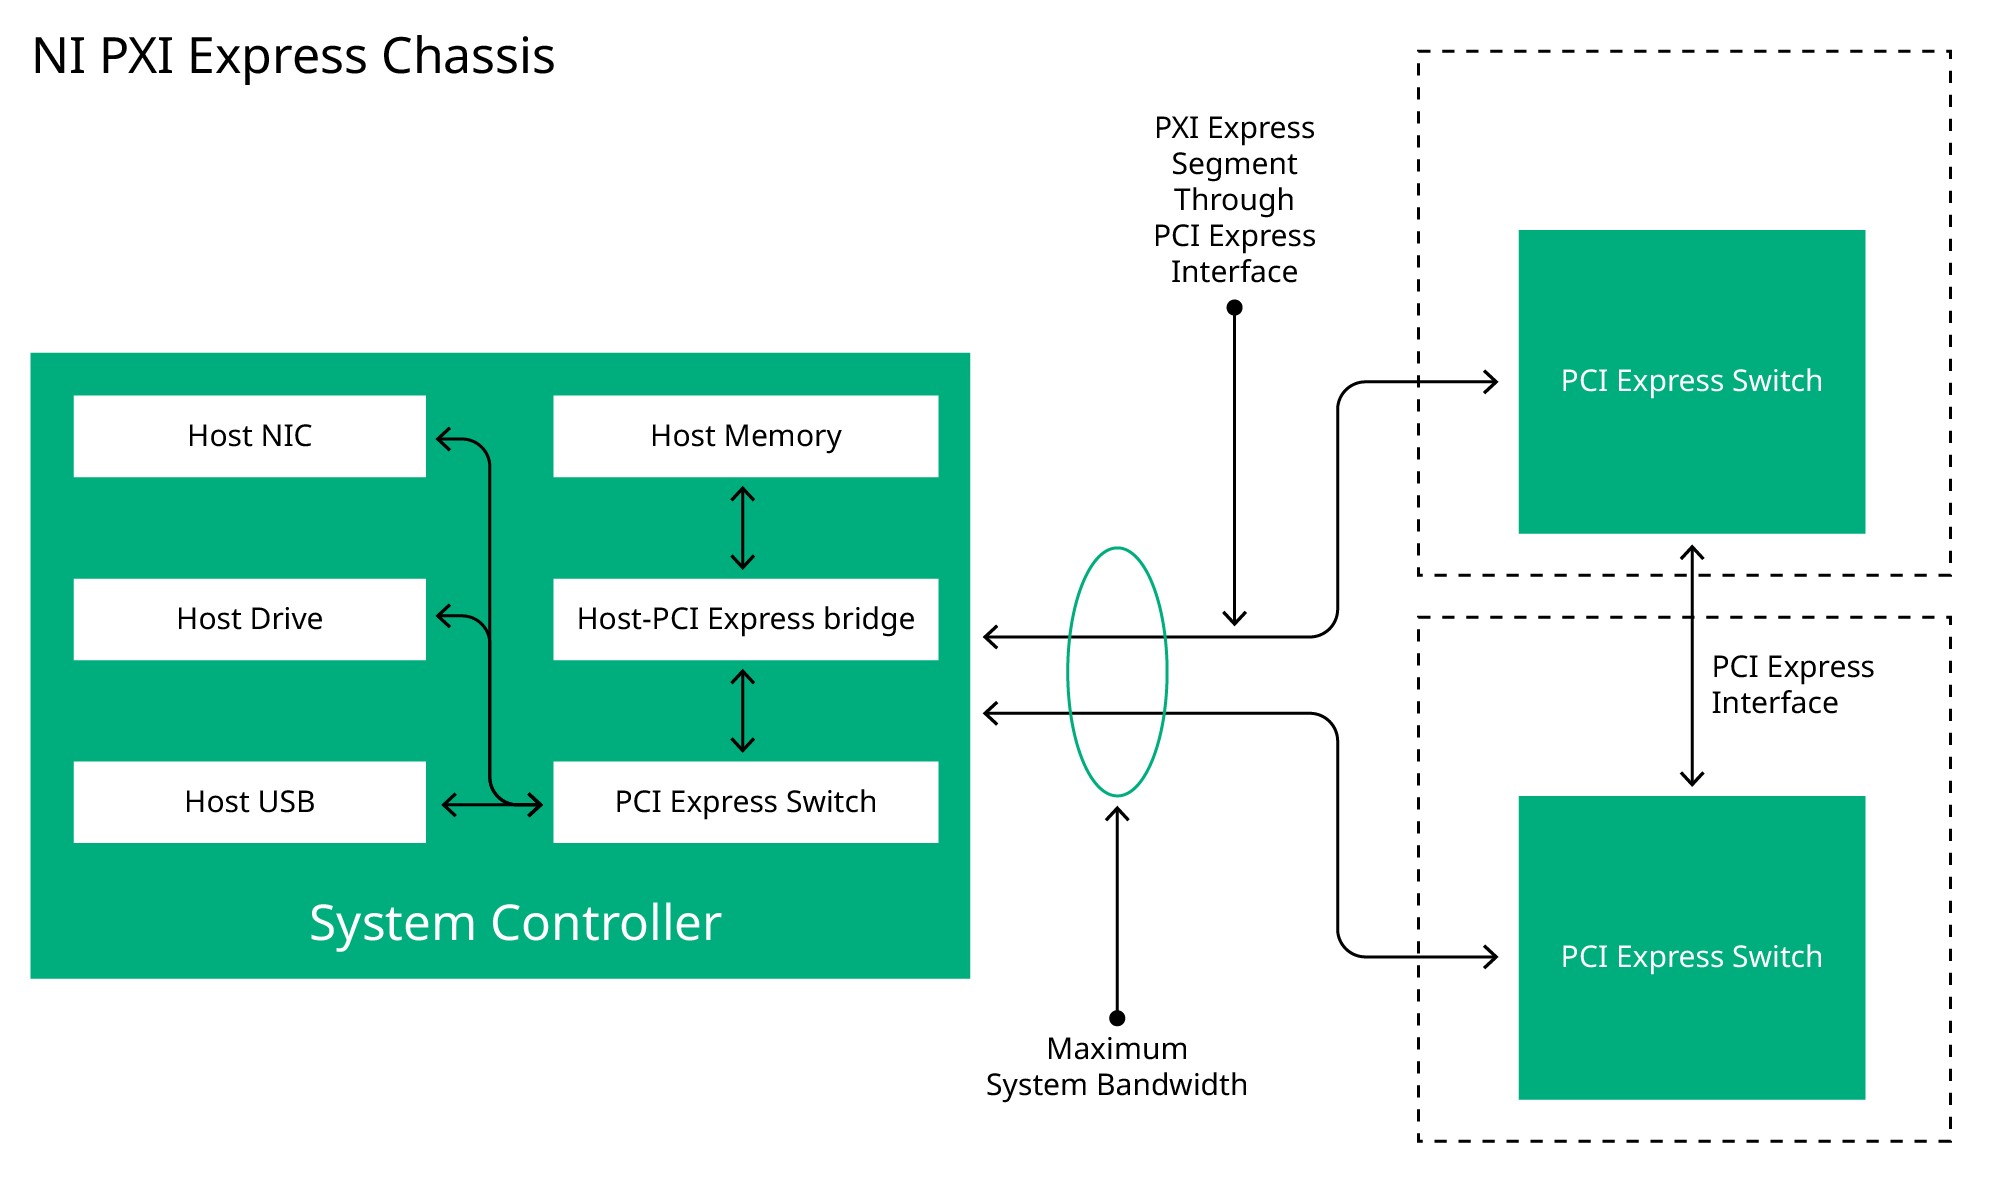
図6:PXIeバックプレーンアーキテクチャ: システムコントローラとPXIeシャーシセグメント間のデータフロー
バックプレーンアーキテクチャと帯域幅パン
さまざまなPXI Expressシャーシには、異なるスロット数、異なるスロット間PCI Express接続速度、異なるセグメントとスロットの関連付け、セグメント間の接続速度、および異なるシステムコントローラスロットと異なるシャーシセグメント間の異なる非対称速度があります。システムの各区間で必要な帯域幅を把握し、余裕のあるシャーシを選択してください。これは、プロトコルのオーバーヘッドを克服しやすくするため、およびシステムの寿命末期における状況の変化に適応しやすくするためです。 必要な帯域幅の2~3倍の帯域幅を計画することをお勧めします。
シャーシバックプレーンの詳細情報を検索するには、次の手順を実行します。
- メイン製品ページに移動します。
- ドキュメント→一般と使用→ユーザマニュアルに移動します。
- ユーザマニュアルで目次を開き、バックプレーンの概要→ハイブリッド周辺スロットに移動します。
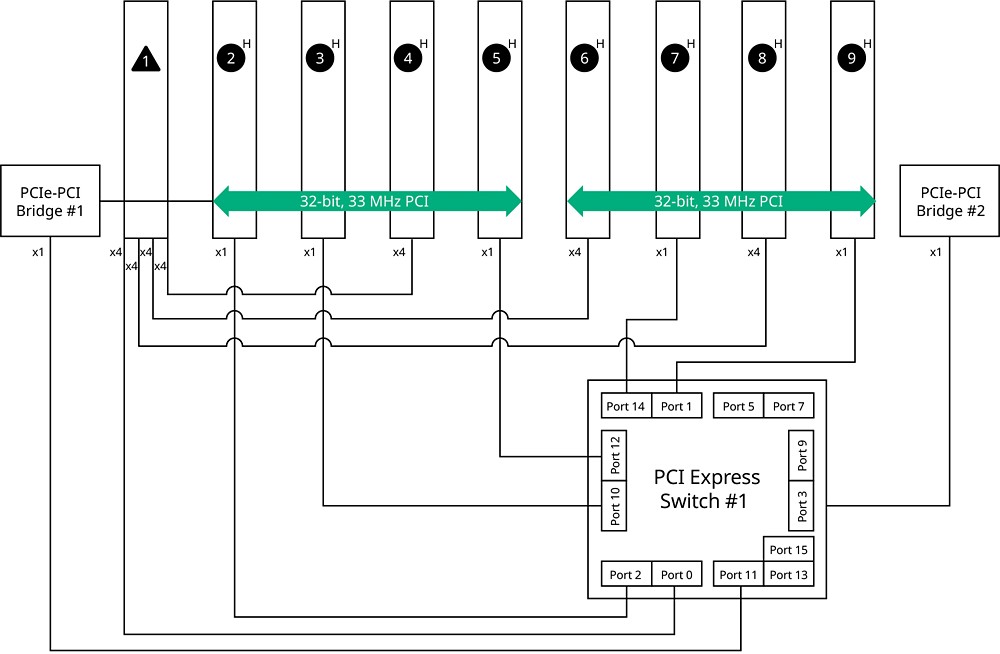
図7: PXIe-1088 PCI Expressバックプレーン図の例 例
図7の図は、スロット4、6、8にはそれぞれシステムコントローラスロットへのx4リンクがあり、スロット2、3、5、7、9にはそれぞれPCI Expressスイッチへのx1リンクがあり、システムコントローラへのx4リンクを共有していることを示しています。さらに、PCIを使用するハイブリッドモジュールでは、スロット2~5はPCIe-PCIブリッジ#1を介してPCI Expressスイッチへのリンクを共有し、スロット6~9はPCIe-PCIブリッジ#2を介してPCI Expressスイッチへのリンクを共有します。
データ移動のボトルネックを回避する方法
すべてのデータをシステムコントローラを介してプッシュすることが不可能または望ましくない場合、システム上のデータ移動の需要を減らす別の方法があります。異なる技術にはさまざまな利点と欠点がありますが、高データレートアプリケーションを扱う際に考慮すべき重要なツールです。 いくつかのテクニックを見てみましょう。
PXI Expressセグメント間の負荷バランシング
1つのバスが1度に処理できる以上の帯域幅を必要とするシステムコールでは、セグメント間で高帯域幅I/Oデバイスを分離し、データ移動のニーズがセグメント間で均等になるようにすることを検討してください。
セグメントの設計の最初のステップは、シャーシのユーザマニュアルを参照して、セグメントの内容と各セグメントからコントローラに割り当てられる帯域幅を確認することです。たとえば、NI PXIe-1092マニュアルの「バックプレーンの概要」セクションには、図 8の「周辺スロット (スロット2~9) からシステムコントローラスロット (スロット1) へのリンク生成とレーン数」が記載されています。
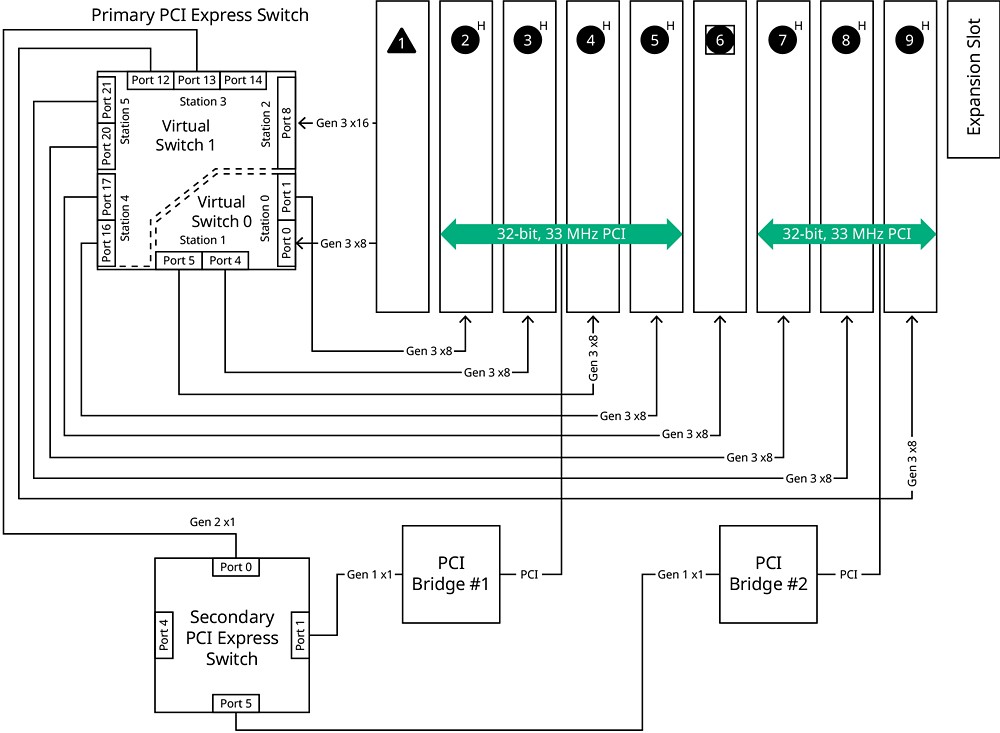
図8: PXIe-1092 PCI Expressバックプレーン図
図 8は、各スロットにスイッチへのGen 3 x8接続があり、システムコントローラに最初のセグメントへのGen3 x8接続 (Virtual Switch 0、スロット2~4をカバー)、2番目のセグメントへのGen 3 x16接続 (Virtual Switch 1、スロット5~9をカバー) があることを示しています。 以下は、いくつかのPXI Expressシャーシのマニュアルに記載されている関連仕様の概要です。
表3:NI PXIeシャーシのデータ移動の比較
計測器データ処理
多くのNI計測器には、NI FlexRIOなどの構成可能なオンボードロジックや、PCI Expressバスを介してデータを移動する前にFFTやその他の形式の高度なデータ処理を実行する再構成可能なデバイスなど、さまざまな機能が搭載されています。この前処理により、シャーシとコントローラに必要な帯域幅を大幅に削減できます。
ピアツーピアストリーミング
多くの高速NI計測器は、ホストメモリを介さず、NI-P2Pと呼ばれるAPIを介してPXI Expressバスセグメントから出ることなく、計測器間のデータストリーミングを直接サポートします。 NI-P2Pは、大量のデータ処理をリアルタイムで行う必要があり、データが複数の計測器から送られてくる場合や、I/O計測器に十分なオンボード処理がないにもかかわらず、PXIe-7903やPXIe-7915などのNI PXI Expressコプロセッサに十分なオンボード処理が必要な場合に非常に役に立ちます。NI-P2Pがシステムにとって最適なソリューションである場合は、データを互いに共有する必要がある計測器を同じシャーシの同じセグメント内に配置しておくと、隣接するバスセグメントへの負担が軽減され、PCI Expressスイッチからのオーバーヘッドも低減されます。 詳細については、「ピアツーピアストリーミングの概要」を参照してください。
DMA FIFOからホストメモリ
ホストメモリへのダイレクトメモリアクセス (DMA) をサポートするデバイスでは、DMAはすべてのメモリI/Oをリアルタイムでホストプロセッサに管理させる負担を回避する上で非常に有効です。通常、ホストはメモリへのすべての書き込みと読み取りを直接管理しますが、DMAではメモリの割り当て部分とストリーミングが必要なデバイスの間に直接リンクを確立できるため、ホストの負担は連続的なメモリ管理操作ではなく、1回限りの構成手順のように見えます。この戦略は、アプリケーションソフトウェアの実行をデータ移動のオーバーヘッドの大部分から分離することで、パフォーマンスを大幅に向上させることができます。
サンプルアプリケーションと製品選択
このセクションでは、いくつかのテストシステムのサンプルと、それぞれのテストシステムを選択した理由について説明します。
ミックスドシグナルとDAQの選択例
テストシステムのサンプルを見て、I/Oの選択からシャーシの選択、そして選択されたシャーシのI/Oデバイスのスロットの選択へと進む方法を見てみましょう。
まず、このサンプルシステムにあるI/Oデバイスと、その理論上のデータスループットのニーズをリストします。
モジュールの最大データレートは、次式で求められます。
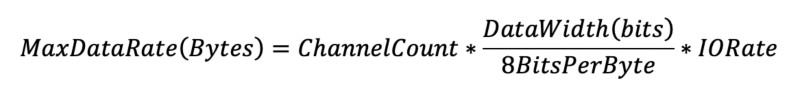
表4では、サンプルのために任意のチャンネルカウントとレートを選択します。
表4: ミックスドシグナルおよびDAQ PXIモジュール
レートとチャンネルカウントは、アプリケーションにおけるシステム設計者の選択に基づいていますが、データ幅とオンボードバッファサイズ (次の手順で説明) はモジュールおよび/またはドライバの仕様です。
たとえば、PXIe-5423の仕様では、DAC分解能は16ビットと宣言されています。
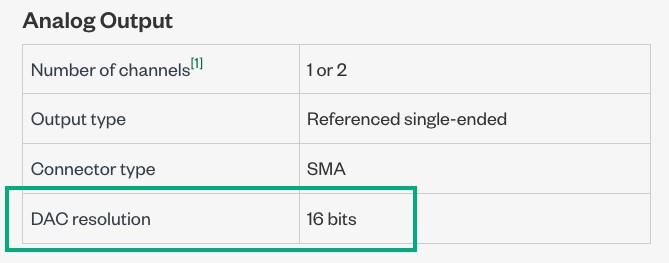
図9:PXIe-5423アナログ出力仕様
メモ:デフォルトでは、PXIe-6396などのDAQモジュールは、レイテンシとオーバーヘッドのパフォーマンスのために最大16ビットまたは32ビットのサンプルをパッドします。そのため、PXIe-6396には18ビット分解能のサンプルがありますが、オンボード圧縮を有効にしない限り、バスで32ビットを使用するため、サンプルレイテンシに影響する可能性があります。
別の例では、PXIe-5172の仕様では、オンボードメモリ (サンプルのバッファとして使用) は8チャンネルバージョンで1.5 GBです。
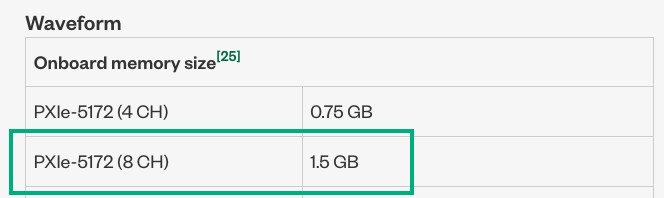
図10:PXIe-5172オンボードメモリ仕様
これらのI/Oデバイスの中には、大量のスループット (4 GB/s以上) を生成するものがあるため、データレートがシャーシの選択に厳しい要件を課せるほど大きい可能性があることを認識しています。これは、どのシャーシが適しているかを判断する前に、さらに掘り下げる必要があることを意味します。 バスオーバーヘッドや将来のアップグレードを簡単に克服するために、システムを再設計せずに、システムが必要とする (可能な場合) 最大スループットの2~3倍の帯域幅を確保します。
このアプリケーションのデータ移動のニーズを理解する次のステップは、これらのデバイスのいずれかがこのアプリケーションでデータをストリーミングする必要があるかどうかを調べることです。 通常、これは2つの部分から解決されます。1つ目は、集録/生成の長さが計測器のオンボードバッファサイズを超えるかどうかを検討し、2つ目は、アプリケーションが特定のレイテンシ要件を持つ計測器間でデータをストリーミングする必要があるかどうかを検討します。
バッファの必要量を計算するには、最長の集録時間または生成時間を最大データレートで乗算してデータストリームのサイズを求めます。次に、そのデータストリームのサイズをデバイスのオンボードバッファのサイズと比較します。たとえば、PXIe-6569を一度に10 msの短いセッションで使用する場合、上記で計算したレートでは、出力バッファに0.010s × 5 GB/s = 50 MB、入力バッファに0.010s × 4 GB/s = 40 MBを使用します。 合計90 MBです。PXIe-6569には4 GBのオンボードDRAMが搭載されているため、これらのレートおよびチャンネルカウントで10 msの間、オンボードメモリはPCI Expressバスの帯域幅を気にすることなくバッファとして使用できる十分なサイズになります。 基本的に、出力データはあらかじめそのデバイスのFPGAにロードまたは生成され、入力データは集録が完了するとオンボードバッファをオーバーランさせることなくデバイスから転送されます。つまり、バックプレーンは、データを書き込む前または読み取る後に移動できるため、計測器ほど高速である必要はありません。ただし、集録/生成の時間がオンボードバッファの容量を超える場合、バックプレーンは計測器に追いつくレートでデータをストリーミングする必要があることが分かっています。
前述したように、レイテンシも考慮する必要があります。 アプリケーションで、ホストまたは特定のレイテンシ要件を持つ別の計測器にデータを転送する必要はありますか。 レイテンシ要件がある場合は、ホストと計測器間でリアルタイムでデータをストリーミングする必要がある可能性があります。また、ストリーミング帯域幅を考慮すべきでない十分なバッファ容量があるとしても、バックプレーンの帯域幅が計測器に追いつく必要がある理由にもなります。
このサンプルでは、設計を評価して、これらの計測器のうちどれがバックプレーンでのリアルタイムストリーミングに依存しているかを理解しました。
表5:ミックスドシグナルおよびDAQ PXIモジュールのストリーミング要件
さらに、これらのストリームが互いに同時であるかを理解する必要があります。このサンプルでは、これらが同時である必要があるとします。
この時点で、シャーシの選択に関する要件を十分に把握しています。少なくとも2.9 GB/s入力と2.5 GB/s出力を同時にサポートできるシャーシが必要です。入力と出力はバス使用率において大きく独立しているため (バスオーバーヘッドに多少の違いがありますが、このサンプルでは無視します)、2.9 GB/s入力というより要求の厳しいレートに要件を絞ることができます。これは理想的には、最大スロット数とシステム帯域幅が6~9GB/sの2~3倍のシャーシを使用することを意味します。 そのため、スロットにGen 3 x8 (8 GB/s) で接続されているシャーシを探しています。 この基準により、PXIe-1085、PXIe-1092、およびPXIe-1095シャーシのオプションが絞り込まれます。
このアプリケーションには10スロットの計測器が必要なため、計測器用に8スロットしかないPXIe-1092は除外されます。そこで、PXIe-1085かPXIe-1095のどちらかを選択します。
アプリケーションがPXIe-6593からこれらのレートでストリーミングする必要がない場合、PXIe-1084またはPXIe-1086を含む適切なシャーシのリストが拡張される可能性があります。これはPXIe-6396の336 MB/sで十分です。
代わりに、このサンプルの「PXIe-6593」を1台ではなく3台使用するなど、追加の「同時ストリーミング」が必要な場合です。スロットあたりPCIe Gen 3 x8に収まるサイズですが、セグメントからコントローラへのGen 3 x8リンクの容量を超えています。 大量のデータストリームを処理するモジュールを複数のセグメントに分散し、システムコントローラに十分な帯域幅を確保する方法を検討する必要があります。その場合、PXIe-1085またはPXIe-1095シャーシが必要で、システムコントローラにGen 3 x8リンクを持つセグメントにPXIe-6593を配置します。残りの2つは、Gen 3 x16リンクをシステムコントローラに接続するセグメントに入ります。
DAQサンプル
別の例として、NI PXIe-6357を中心としたHILフォーカスDAQシステムを見てみましょう。この例では、2,000チャンネルのアナログ入力、10チャンネルのアナログ出力、120チャンネルのスタティックデジタル入力、80チャンネルのデジタル出力が必要です。 また、アプリケーションは1ミリ秒のループレートで実行します。 そのため、1,000 Hzでサンプリングします。
表6:HILフォーカスDAQシステムチャンネルカウントとデータレート
このサンプルシステムでは、チャンネル数は多いですが、大量のデータスループットは必要ありません。すべての入力を足した合計は4.15 MB/s、すべての出力の合計は0.12 MB/sです。これは、どのNI PXIeシャーシでも実行できるほど低いスループットです。
ただし、2,000チャンネルのアナログ入力が必要なPXIe-6357を使用しているため、少なくとも10台のPXIe-6357が必要となり、計測用に少なくとも10個のスロットを備えたシャーシが必要になります。
その要件に基づいて、PXIe-1081、PXIe-1084、PXIe-1085、PXIe-1086、PXIe-1095シャーシのいずれかを選択し、これらのシャーシモデルを使用してアプリケーションのデータ移動のニーズを満たすことができます。
まとめ
シャーシの選択は、モジュール式テストのシステム設計の重要な要素です。PXIでは、サイズ、スロットあたりの電力、タイミングおよび同期機能から、PXIハイブリッドモジュールのサポート、動作条件、データ移動機能まで、すべてに影響します。シャーシ内での効率的なデータ移動は、PXIベースのテストシステムで信頼性の高いパフォーマンスを実現するために不可欠です。
データ移動に適切なPXI Expressシャーシを選択するには、システム内の個々のモジュールとシステム全体のスループットを考慮する必要があります。エンジニアは、スロットあたりの帯域幅のニーズを評価し、セグメント分布を理解し、同時に動作するすべての計測器をサポートするのに十分なシステム帯域幅を確保する必要があります。同様に重要なのは、シャーシの性能に合ったPXI Expressコントローラを選択することです。
NIでは、データ移動のボトルネックを回避するために、PXI Expressセグメント間で負荷を分散させる方法、計測器との直接通信にピアツーピア (P2P) ストリーミングを使用する方法、オンボードまたはFPGAベースの処理を利用してホストからデータ処理をオフロードする方法があります。
適切に計画すれば、NIモジュール式プラットフォーム上に構築されたPXIシステムは、スケーラブルで高スループットのテストアプリケーションのための堅牢な基盤となります。
次のステップ
アプリケーションに適したNI PXIシャーシを選択するには、以下の手順に従ってください。
- PXIシャーシ購入ページを使用して、最大システム帯域幅でフィルタ処理します。
- PXIシャーシポートフォリオの完全な比較については、「PXIシャーシのパンフレット」をダウンロードしてください。
- シャーシモデルがすでにわかっている場合は、製品ページを参照してください。
- 詳細なバックプレーン図と帯域幅仕様については、シャーシモデルのユーザマニュアルを参照してください。モデルのメイン製品ページからドキュメント→一般と使用法→ユーザマニュアル→バックプレーンの概要→ハイブリッド周辺スロットからアクセスできます。
NI PXI Expressシャーシ、コントローラ、およびモジュールのフルポートフォリオと、今日の要求を満たし、将来に向けた拡張性を備えたシステムの設計を支援するエキスパートサポートを提供します。リソースを参照するか、NIエンジニアにお問い合わせください。
| PCI Express Generation | レーンあたりの速度 | レーン幅 | 最大スロットあたり帯域幅 |
|---|---|---|---|
| Gen 1 | 250 MB/秒 | x1~x4 | 最大1 GB/s |
| Gen 2 | 500 MB/秒 | x1~x8 | 最大4 GB/s |
| Gen 3 | 1 GB/s | x1~x8 | 最大8 GB/s |
| PXIモジュールタイプ | 標準データレート (モジュールあたり) |
|---|---|
| データ収集 (DAQ) デバイス | 0.1~250 MB/s |
| DMM | <0.1 MB/s |
| SMU | 1~30 MB/s |
| 波形発生器/オシロスコープ | 250 MB/s~5 GB/s |
| 高速DIOおよび高速シリアル | 100 MB~10 GB/s |
| RF | 5~20 GB/s |
| モデル | 合計スロット数 | システム帯域幅 | PCI Expressセグメント | コントローラへのリンク速度 | セグメントあたりのスロットカバレッジ | スロットへのリンク速度 |
|---|---|---|---|---|---|---|
| NI PXIe-1071 | 4 | 3 GB/s | 1 | Gen x4/スロット | セグメントなし | Gen 1 x4 |
| NI PXIe-1073 | 5 | 250 MB/s | 1 | Gen 1 x 1 (MXI-Express) | セグメント1:スロット2~5 | Gen 1 x1 |
| NI PXIe-1081 | 18 | 2 GB/s | 2 | Gen 1 x4/セグメント | セグメント1:スロット2~9; セグメント2:スロット10~18 | Gen 1 x1 |
| NI PXIe-1083 | 5 | 2 GB/s | 1 | Thunderbolt™ 3~Gen 2 x4 | セグメント1:スロット2~5 | Gen 2 x1 |
| NI PXIe-1084 | 18 | 4 GB/s | 2 | Gen 2 x4/セグメント | セグメント1:スロット2~9; セグメント2:スロット10~18 | Gen 2 x1 |
| NI PXIe-1085 | 18 | 24 GB/s | 2 | Gen 3 x8 Gen 3 x16 | セグメント1:スロット2~10; セグメント2:スロット11~18 | Gen 3 x8 |
| NI PXIe-1086 | 18 | 12 GB/s | 2 | Gen 2 x8 Gen 2 x16 | セグメント1:スロット2~9; セグメント2:スロット10~18 | Gen 2 x8 |
| NI PXIe-1088 | 9 | 8 GB/s | 4 | Gen 2 x4 | Gen2 x4/スロット:4スロット、6スロット、8スロット 共有Gen2 x4:スロット2、3、5、7、9 | Gen 2 x4 Gen 2 x1 |
| NI PXIe-1090 | 2 | 2 GB/s | 1 | Thunderbolt 3~Gen 2 x4 | セグメント1:スロット1~2 | Gen 3 x1 |
| NI PXIe-1092 | 9 | 24 GB/s | 2 | Gen 3 x8 Gen 3 x16 | セグメント1:スロット2~4; セグメント2:スロット5~9 | Gen 3 x8 |
| NI PXIe-1095 | 18 | 24 GB/s | 2 | Gen 3 x8 Gen 3 x16 | セグメント1:スロット2~10; セグメント2:スロット11~18 | Gen 3 x8 |
| モデル | 機能 | 使用されたチャンネル数 | チャンネルあたりのデータ幅 | 最大I/Oレート (アプリケーション) | 最大データレート (計算) | オンボードバッファサイズ |
|---|---|---|---|---|---|---|
| NI PXIe-6569 | LVDS | 40出力 | 1ビット | 1 GS/s | 5 GB/s出力 | 4 GB |
| NI PXIe-6569 | LVDS | 32インチ | 1ビット | 1 GS/s | 4 GB/s入力 | 4 GB |
| NI PXIe-6593 | HSS | 2レーン入力 2レーン出力 | 1ビット | 10 Gb/s | 2.5 GB/s入力 2.5 GB/s出力 | 4 GB |
| NI PXIe-6396 | DAQ | 8インチ | 32ビット | 14 MS/s | 336 MB/s入力 | 8196サンプル |
| NI PXIe-5423 | AWG | 2 | 16ビット | 400 MS/s | 1.6 GB/s出力 | 64 Mサンプル |
| NI PXIe-5163 | スコープ | 2 | 14ビット | 1 GS/s | 4 GB/s入力 | 512 MB |
| NI PXIe-5172 | スコープ | 8 | 14ビット | 250 MS/s | 4 GB/s入力 | 1.5 GB |
| NI PXIe-4082 | DMM | 1 | 24ビット | 20 kS/s | 60 kS/s入力 | — |
| NI PXI-2594 | Mux/スイッチ | n/a | n/a | ごくわずか | ごくわずか | — |
| NI PXI-2576 | Mux/スイッチ | n/a | n/a | ごくわずか | ごくわずか | — |
| モデル | 機能 | 最大データレート | ストリーミングが必要? |
|---|---|---|---|
| PXIe-6569 | LVDS | 5 GB/s出力 | いいえ |
| PXIe-6569 | LVDS | 4 GB/s入力 | いいえ |
| PXIe-6593 | 高速シリアル | 2.5 GB/s入力 2.5 GB/s出力 | はい |
| PXIe-6396 | DAQ | 336 MB/s入力 | はい |
| PXIe-5423 | 波形発生器 | 1.6 GB/s出力 | いいえ |
| PXIe-5163 | オシロスコープ | 4 GB/s入力 | いいえ |
| PXIe-5172 | オシロスコープ | 4 GB/s入力 | いいえ |
| PXIe-4082 | DMM | 60 kS/s入力 | いいえ |
| PXI-2594 | マルチプレクサ/スイッチ | ごくわずか | いいえ |
| PXI-2576 | マルチプレクサ/スイッチ | ごくわずか | いいえ |
| モデル | 機能 | チャンネル数 | データ幅/チャンネル | 最大I/Oレート (アプリケーション) | 最大データレート |
|---|---|---|---|---|---|
| アナログ入力 アナログ出力 デジタル入力 デジタル出力 | 2000 10 120 80 | 16ビット 16ビット 1ビット 1ビット | 1,000 S/s 1,000 S/s 1,000 S/s 1,000 S/s | 4 MB/s入力 0.02 MB/s出力 0.15 MB/s入力 0.10 MB/s出力 |