Accélération matérielle des systèmes de test avec les GPU et NI LabVIEW
Aperçu
Les systèmes de test modernes exigent un traitement à haut débit, et les GPU offrent une solution puissante avec leur parallélisme massif, idéal pour le traitement du signal, l’analyse d’images et l’inférence IA. LabVIEW, associé à des toolkits tiers comme Ngene, Graiphic et G²CPU, permet une accélération GPU fluide sans courbes d’apprentissage raides.
Les ingénieurs peuvent intégrer des GPU dans leurs systèmes de test via des modules RADX PXI Express (PXIe), des extensions MXI Express (MXIe) ou des serveurs GPU en réseau, augmentant significativement la vitesse de test et la scalabilité système. Avec des outils intuitifs et des options de déploiement flexibles, l’accélération GPU est désormais accessible dans la plateforme NI, permettant des flux de travail de test plus rapides, évolutifs et prêts pour l’avenir.
Contenu
- Pourquoi l’accélération matérielle est-elle essentielle aux systèmes de test modernes ?
- Comment les GPU se comparent-ils aux FPGA et aux CPU pour les applications de test et de mesure ?
- Accélération GPU dans LabVIEW avec des toolkits tiers
- Connexion d’un GPU au matériel NI
- Plates-formes matérielles RADX et NI
- Résumé et points clés
Pourquoi l’accélération matérielle est-elle essentielle aux systèmes de test modernes ?
Ce livre blanc explore l’utilisation stratégique des GPU comme accélérateurs matériels pour gérer les demandes croissantes des applications de test à forte intensité de calcul. Alors que les industries misent de plus en plus sur le traitement à haut débit pour améliorer l’efficacité des tests, le calcul évolutif et haute performance devient indispensable. Les GPU, grâce à leur parallélisme massif et leurs milliers de cœurs, offrent un avantage significatif par rapport aux CPU traditionnels, les rendant idéaux pour des tâches telles que le traitement d’images et de signaux, l’inférence en apprentissage profond et les calculs matriciels.
En intégrant les GPU à NI LabVIEW et en utilisant un matériel et des toolkits compatibles, l’accélération GPU peut être adoptée efficacement et intégrée de manière transparente dans les systèmes de test existants. Cette approche offre un framework intuitif permettant aux ingénieurs et architectes systèmes de maximiser l’accélération matérielle dans leurs flux de travail. Le choix de la plateforme matérielle appropriée apporte des bénéfices tels qu’une augmentation de la vitesse de traitement, une réduction de la latence, une meilleure efficience énergétique et des performances évolutives pour les applications futures.
Comment les GPU se comparent-ils aux FPGA et aux CPU pour les applications de test et de mesure ?
Les GPU excellent dans les tâches impliquant des réseaux neuronaux, le traitement d’images et les simulations grâce à leurs capacités de traitement parallèle inégalées. Cependant, les avantages du parallélisme des GPU ne sont visibles qu’à grande échelle, car le délestage des tâches vers les GPU implique des transferts de données coûteux, une synchronisation pour assurer la cohérence des données et des délais de lancement des noyaux. Les GPU ne conviennent pas aux petits ensembles de données caractérisés par un faible volume de données et une forte variance dans les opérations de calcul.
Les FPGA offrent une architecture personnalisable idéale pour les systèmes déterministes tels que les systèmes embarqués et le traitement du signal en temps réel. Ils proposent des environnements de traitement optimisés et des solutions basse consommation, cruciales pour les modèles d’IA soumis à des contraintes d’énergie. Cependant, la programmation des FPGA pour une performance optimale implique des frais généraux.
Les processeurs généraux ont généralement un nombre plus réduit de cœurs de calcul, chaque cœur étant associé à sa propre unité de contrôle, ce qui offre flexibilité et contrôle. Les CPU mettent davantage l’accent sur les unités de contrôle comparés aux GPU, ce qui permet notamment la commutation contextuelle monocœur.
Les plateformes modulaires NI utilisent des CPU pour la flexibilité et la logique de contrôle complexe, et des FPGA pour le déterminisme et le contrôle précis. Et désormais, l'ajout des GPU apporte un troisième pilier d’accélération axée sur le débit.
Accélération GPU dans LabVIEW avec des toolkits tiers
LabVIEW offre de puissantes capacités natives et une large gamme de fonctionnalités intégrées pour diverses applications; cela est renforcé par des toolkits tiers permettant une intégration aisée de l’accélération GPU. Ces toolkits sont intuitifs et proches de l’expérience native LabVIEW, réduisant ainsi la courbe d’apprentissage pour les développeurs. Ils ajoutent des fonctions spécialisées pour l’utilisation du GPU, aidant les utilisateurs à exploiter la puissance des GPU sans devoir développer tous les composants depuis zéro. Cette section présente trois toolkits tiers majeurs de l’écosystème NI facilitant l’accélération GPU pour diverses applications, en se concentrant sur leurs caractéristiques et leurs architectures efficaces pour répondre à des critères élevés de performance.
Le toolkit Ngene CuLab
Les applications modernes en ingénierie et sciences requièrent une puissance de calcul importante, notamment dans le traitement des signaux RF, la surveillance et l’analyse en temps réel, le calcul scientifique et la modélisation, ainsi que la vision industrielle. Bien que les GPU soient parfaitement adaptés à ces tâches grâce à leur parallélisme, LabVIEW manquait de support natif pour l’accélération GPU, ce qui représente un défi pour les ingénieurs peu familiers avec CUDA ou C++.
Le toolkit Ngene CuLab comble ce vide en offrant une solution d’accélération GPU haute performance directement intégrée à LabVIEW. Il propose une API proche de LabVIEW, permettant aux ingénieurs d’accélérer les calculs sans codage complexe. CuLab simplifie l’intégration, offre une gamme complète de fonctions accélérées par GPU et affiche des performances supérieures, en moyenne six fois plus rapides que des frameworks Python tels que CuPy.
CuLab offre plusieurs avantages clés. Il s’intègre parfaitement via une API de type LabVIEW et offre une amélioration de plus de 100 fois1 pour les tâches de traitement de données par rapport à LabVIEW basique fonctionnant sur CPU. La plateforme inclut plus de 150 fonctions accélérées par GPU pour gérer efficacement les tableaux multidimensionnels et tous types de données numériques.
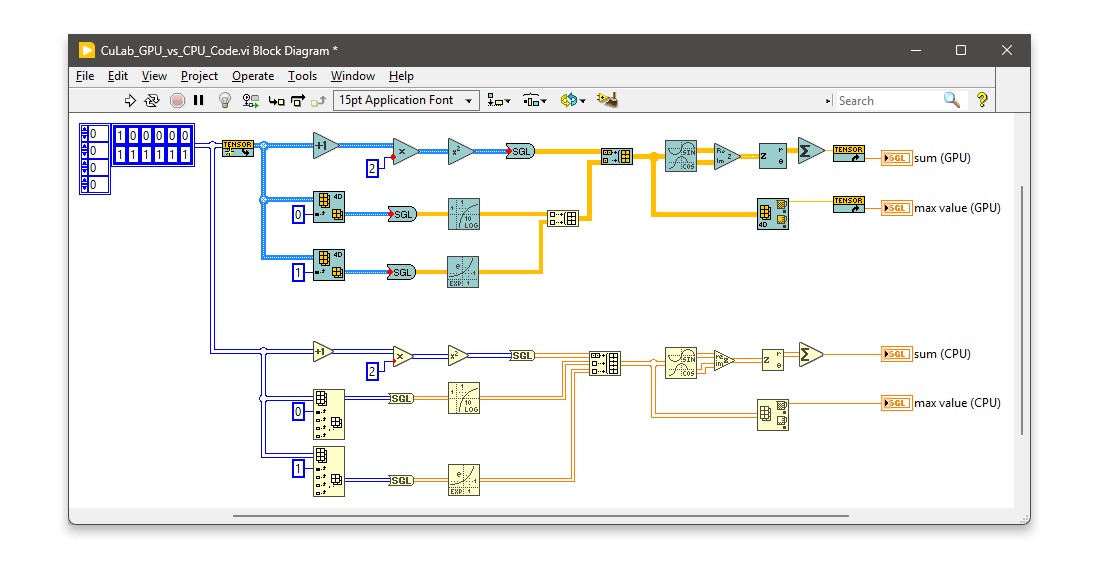
Figure 1. Ce programme illustre la similitude entre les implémentations natives de LabVIEW et celles de CuLab.
La fonctionnalité de CuLab est étendue et imite celle de LabVIEW natif. La liste complète des fonctions inclut les opérations vectorielles et matricielles, l’algèbre linéaire, le traitement du signal, la vision par ordinateur, les fonctions mathématiques et les opérations logiques.
Le toolkit Graiphic SOTA
L’écosystème SOTA pour LabVIEW de Graiphic introduit des capacités d’accélération GPU avancées, offrant une alternative aux frameworks d’apprentissage profond comme PyTorch et TensorFlow. Il transforme LabVIEW en un éditeur et orchestrateur universel de graphes avec un support ONNX étendu pour l’entraînement et le calcul sur différents matériels. Offrant des abstractions de haut et bas niveau, il convient aux ingénieurs cherchant un déploiement simple comme aux chercheurs souhaitant un contrôle détaillé, répondant ainsi à un large éventail de besoins en apprentissage profond.
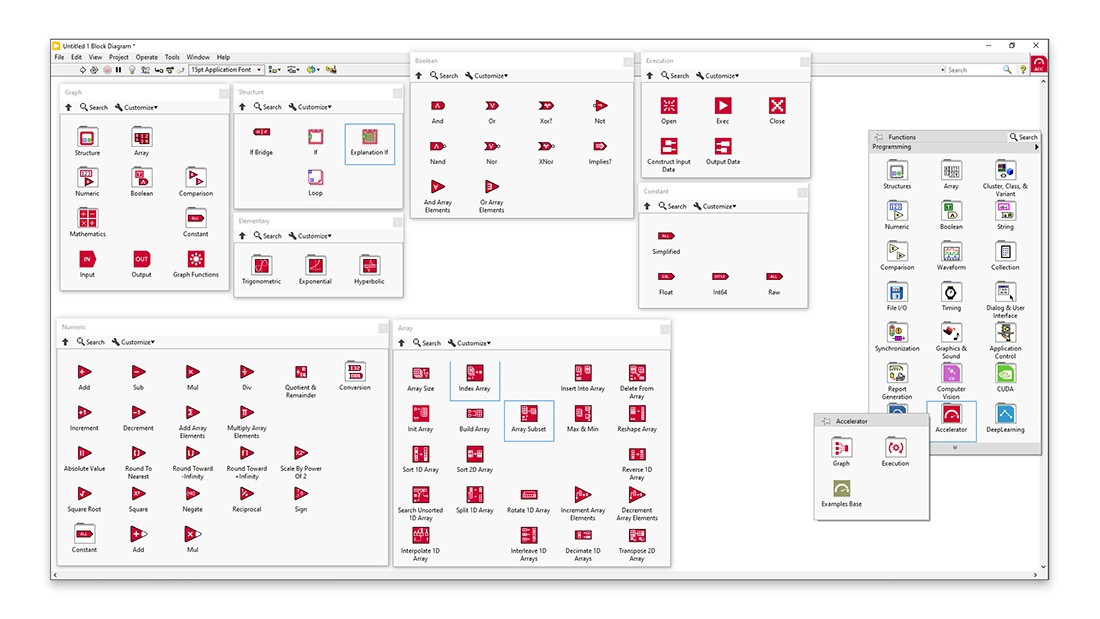
Figure 2. La palette accélérateur vise une couverture complète des opérations standard LabVIEW. Elle gère efficacement l’orchestration dynamique et offre une grande flexibilité pour supporter différents fournisseurs d’exécution. Une référence publique cartographie la couverture des nœuds à travers plusieurs backends.
SOTA rivalise avec les frameworks existants grâce à un ensemble complet de fonctionnalités, généralisées par son toolkit d’accélérateur qui étend la palette de fonctions LabVIEW pour orchestrer des graphes de calcul via ONNX.
Les composants clés de l’écosystème SOTA incluent le toolkit d’apprentissage profond pour l’entraînement et l’inférence, le toolkit de vision par ordinateur pour le traitement d’images, le toolkit GenAI pour les modèles à base de transformateur, ainsi que le toolkit d’accélérateur mentionné auparavant. Ces toolkits excellent en vision par ordinateur, apprentissage profond, GenAI et apprentissage par renforcement, avec une intégration ONNX fluide optimisant les performances sur les plateformes matérielles. Il démocratise le développement de l’IA par la programmation visuelle de flux de données, permettant aux utilisateurs sans compétences en programmation de créer des flux de travail complexes.
SOTA optimise l’étiquetage des données, la formation des modèles IA, leur réglage et leur déploiement sur des matériels hétérogènes.
Toolkit Natan Biesmans LabVIEW G²CPU High Performance Compute
G²CPU offre un toolkit de calcul haute performance pour LabVIEW, permettant l’exécution de code indépendante de la plateforme sur CPU, GPU NVIDIA CUDA, dispositifs OpenCL et tout l’écosystème NI. Basé sur la bibliothèque open source ArrayFire, il simplifie le changement de backend pour une stabilité à long terme.
Avantages principaux
- Abstraction unifiée des backends : écrivez le code une fois et déployez-le sur CPU, CUDA et OpenCL sans modifications, augmentant ainsi la flexibilité. Ce toolkit est utilisable dans l’écosystème NI incluant les dispositifs Windows et Linux, le module LabVIEW Real Time, PXI et les ordinateurs industriels.
- Intégration transparente : les fonctions reflètent les opérations LabVIEW natives, facilitant l’intégration avec une courbe d’apprentissage minimale. Le débogage est supporté via des sondes pouvant inspecter les données à travers différents backends directement dans l’environnement LabVIEW.
- Grande flexibilité de code : implémentez même les algorithmes les plus complexes sur GPU tout en restant dans l’IDE natif LabVIEW.
- Hautes performances : jusqu’à 200 fois plus rapide2 pour les tâches intensives, avec des vitesses I/O GPU de 7 Go/s sur NI PXI et plus de 22 Go/s sur systèmes modernes. Il supporte des boucles sub-ms dans le NI LabVIEW Real-Time Module pour les applications sensibles au temps.
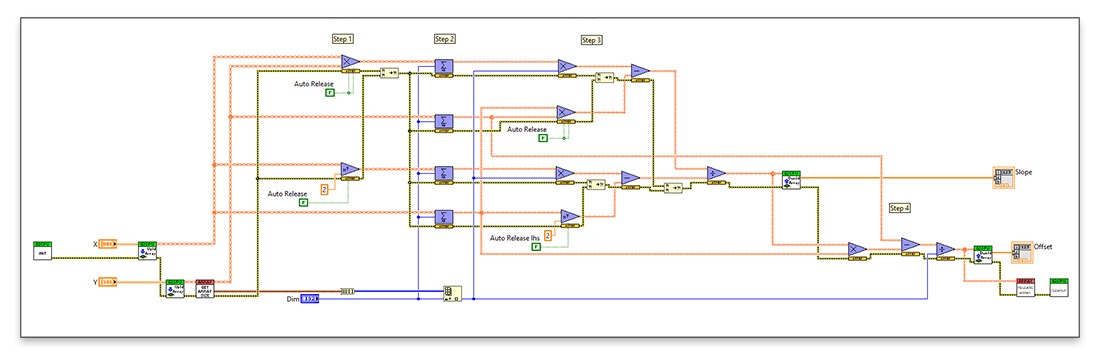
Figure 3. Ce programme montre un algorithme d’ajustement linéaire entièrement écrit en G²CPU. Notez la similitude avec LabVIEW natif.
Le toolkit logiciel offre une suite complète de fonctions puissantes pour diverses tâches incluant mathématiques, traitement du signal, vision industrielle, accélération de l’interface utilisateur, et bien plus, utilisables sur tout type de GPU et système d’exploitation. Il propose des capacités de transfert de données à haute vitesse, permettant une intégration fluide avec des périphériques tels que le transcepteur de signaux vectoriels (VST) PXI NI, le matériel NI compatible FPGA et les cartes d’acquisition d’images NI, entre autres. Rendu possible grâce à des transferts de données zero-copy efficaces entre dispositifs et GPU, G²CPU est un toolkit très flexible et performant, extensible avec des noyaux GPU personnalisés et des toolkits tiers, permettant une intégration fluide avec des toolkits comme NVENC, LibTorch, OpenCV, et bien d’autres. G²CPU est une solution idéale pour les développeurs nécessitant des performances exceptionnelles avec un développement libre dans tous les domaines.
Connexion d’un GPU au matériel NI
Cette section traite de la connexion à un serveur GPU ainsi que des configurations PXI Express vers MXI Express.
Connexion réseau à un serveur GPU
La connexion à un serveur GPU peut être efficacement réalisée via des cartes d’interface réseau (NIC) et des NIC intelligentes, qui offrent des capacités avancées pour une performance réseau optimisée. Les NIC intelligentes intègrent des composants CPU et GPU pour supporter des tâches de calcul et de traitement parallèle exigeantes. Elles déchargent intelligemment le traitement réseau pour réduire la charge système, améliorant ainsi l’efficacité du flux de données vers le serveur GPU. Les NIC intelligentes peuvent améliorer la gestion des données sur les réseaux, supportant des applications de calcul distribué avec une bande passante jusqu’à 25 Go/s, permettant une utilisation plus efficace des ressources GPU en réseau. D’autres matériels NI, y compris les systèmes NI CompactRIO et NI CompactDAQ, peuvent utiliser des connexions réseau Ethernet ou USB pour interagir avec et utiliser les ressources des serveurs GPU.
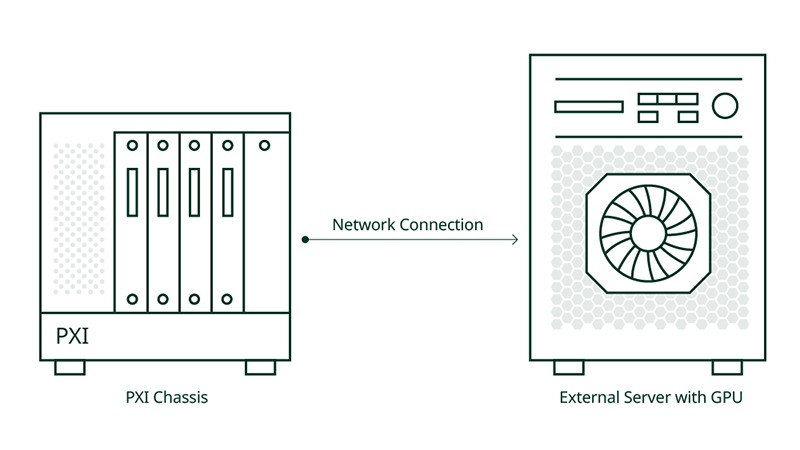
Figure 4. Un châssis PXI est connecté à un serveur GPU externe pour un calcul accéléré à haute vitesse via NIC ou NIC intelligente.
PXI Express vers MXI Express
Les configurations PXIe vers MXIe sont avantageuses pour les installations nécessitant des capacités GPU externes, notamment en calcul haute performance. En connectant des châssis PXIe avec des interfaces MXIe, les utilisateurs peuvent accéder à des GPU externes puissants, augmentant la capacité de calcul au-delà des limites matérielles locales. Cette configuration est idéale pour les espaces restreints et les scénarios nécessitant plusieurs GPU répartis sur différents systèmes pour des tâches telles que le traitement massif de données, le développement IA ou les simulations. L’interface Gen 3 x16 MXIe prend en charge des vitesses de transfert de données de 16 Go/s, réduisant les goulots d’étranglement et permettant aux applications exigeantes d’utiliser efficacement les ressources GPU externes ou de serveur GPU.
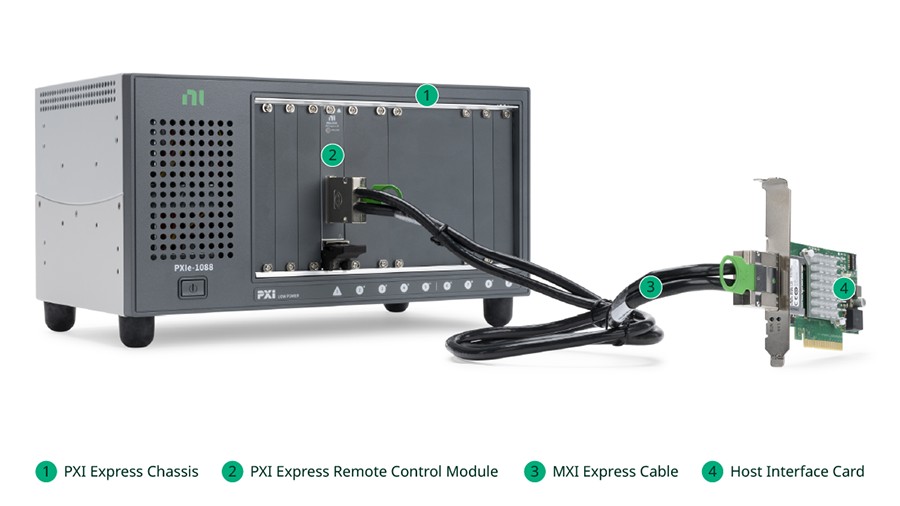
Figure 5. Un châssis PXIe est connecté à un serveur GPU via extension MXIe, permettant un transfert de données à haute bande passante pour un traitement accéléré et des calculs avancés.
Plates-formes matérielles RADX et NI
RADX Technologies Inc. propose des modules GPU PXI Express commerciaux prêts à l’emploi (COTS) conçus pour l’écosystème NI, mais distincts des offres NI. Basés sur les GPU NVIDIA Turing, Ampere et Ada, ces modules s’intègrent parfaitement dans des châssis PXI Express comme le NI PXIe-1092 ou le NI PXIe-1095, augmentant la puissance de calcul pour les environnements de test et mesure. Les GPU RADX PXIe supportent de nombreuses applications telles que l’acquisition de données et le machine learning, utilisant des outils comme LabVIEW et Python, sans nécessiter de serveurs GPU dédiés.
Les GPU embarqués RADX Technologies offrent de 1,7 à 30,3 TFLOPS FP32 avec 4 Go à 24 Go de mémoire. Cependant, ces configurations peuvent subir des goulots d’étranglement de données dus à l’absence de communication pair-à-pair entre GPU, sauf sous Linux. Des techniques comme le zero-copy sont nécessaires pour atténuer ces limitations, exploiter pleinement les capacités GPU et réduire ces goulots d’étranglement. Les GPU RADX sont qualifiés pour les systèmes NI et sont souvent couplés avec G²CPU pour un traitement du signal accéléré par GPU dans LabVIEW.
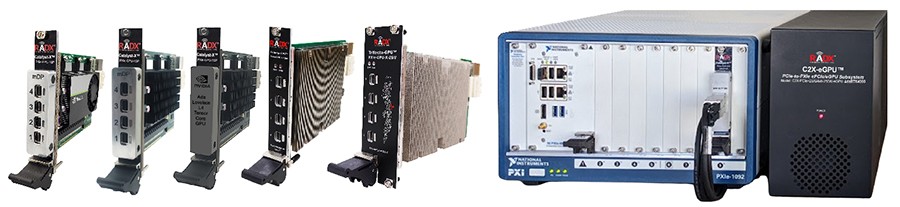
Figure 6. Modules et offres GPU compatibles RADX PXIe
Résumé et points clés
En conclusion, les GPU sont de plus en plus adoptés par les ingénieurs de test pour accélérer les tests en raison de leurs performances et programmabilité exceptionnelles. Leur parallélisme massif et leur puissance de calcul évolutive les rendent idéaux pour des applications volumineuses en données comme le traitement du signal, l’analyse d’images, les simulations et le contrôle basé sur modèle. Toutefois, en raison de leurs exigences en données, les GPU restent un ajout de niche pour les flux de travail adaptés.
L’intégration de l’accélération GPU dans l’écosystème NI, utilisant des GPU partenaires pris en charge par PXI Express et des toolkits LabVIEW, démocratise l’usage du GPU pour les ingénieurs de test en apportant un complément flexible et performant aux flux de travail existants. Cette intégration dans des environnements familiers abaisse la barrière d’entrée, permettant un prototypage plus rapide, un débit de données efficace et une meilleure scalabilité système.
Comprendre comment utiliser efficacement les GPU offre aux organisations de test et mesure un avantage concurrentiel dans la conception de systèmes évolutifs. Reconnaître les gains de performance des GPU, exploiter les outils adaptés et identifier les tâches intensives en calcul sont des étapes clés.
1 Regardez une démonstration enregistrée montrant comment CuLab (GPU Toolkit pour LabVIEW) accélère les applications RF RTSA.
2 Pour plus d’informations, visitez g2cpu.com.
| Domaine d’application | Domaines où les GPU excellent |
|---|---|
| Enregistrement RF et lecture / analyse spectrale | FFT temps réel multi-gigahertz, canaux polyphases et rendu de spectrogrammes |
| Vision haute vitesse / inspection basée sur l’image | Les réseaux neuronaux convolutionnels (CNN) et les filtres OpenCV classiques traitent des centaines de trames par seconde |
| Analyse massive de waveforms | Traitement par lots de millions de waveforms avec filtres, corrélations ou détection d’anomalies par apprentissage profond |
Tableau 1. Exploiter la puissance des GPU pour des tâches dans des domaines d’application clés
| Fonctionnalités | Processeur | FPGA | GPU |
|---|---|---|---|
| Excellent pour | Logique séquentielle lourde en branches ; services OS, charges de travail AI/ML plus petites (de l'ordre de centaines de GFLOPs) | Latence au niveau de la nanoseconde ; protocoles d’E/S personnalisés | Maths parallèles à l’échelle téraflop/pétaflop ; charges de travail AI/ML |
| Déterminisme | Jitter de 10 µs à ms (OS préemptif) | Exécution précise au cycle près ; synchronisation déterministe au niveau matériel | Jitter modéré ; exécution déterministe au sein des noyaux lancés |
| Flux de développement | C/C++, LabVIEW RT, Python | LabVIEW FPGA, VHDL/Verilog, HLS | CUDA/HIP, Toolkits LabVIEW GPU, Python (Numba/CuPy) |
| Coût du re-ciblage | Aucun | Élevé (synthèse, validation du timing) | Faible (recompilation du noyau en quelques secondes) |
| Usage typique dans le test et la mesure | Séquençage, interface utilisateur hôte, enregistrement des données | Cadencement précis, déclenchement personnalisé, filtrage en ligne | FFT, spectrogrammes, inférence d’apprentissage profond, opérations sur grandes matrices |
Tableau 2. Choix du moteur adéquat : CPU, GPU ou FPGA ?
Étapes suivantes
- Découvrez le toolkit Natan Biesmans LabVIEW G²CPU High Performance Compute sur le réseau des outils NI
- Procurez-vous le Ngene CuLab - GPU Accelerated Toolkit sur le réseau des outils NI
- Explorez et téléchargez le toolkit SOTA sur le site Web de Graiphic
- Visitez le site Web de RADX Technologies Inc. pour plus de détails et d’offres
- Pour en savoir plus sur les toolkits Ngene, consultez leur site Web
- Découvrez davantage le toolkit G²CPU en visitant leur site Web
Windows est une marque déposée du groupe Microsoft. La marque déposée Linux® est utilisée selon les termes d’une sous-licence de LMI, le détenteur exclusif de la licence de Linus Torvalds, propriétaire de la marque au niveau mondial.