Aceleración de hardware del sistema de prueba con GPU y NI LabVIEW
Información general
Los sistemas de prueba modernos exigen un procesamiento de alto rendimiento, y las GPU ofrecen una solución potente con un paralelismo masivo ideal para tareas como procesamiento de señales, análisis de imágenes e inferencia de IA. LabVIEW, combinado con kits de herramientas de terceros como Ngene, Graiphic y G²CPU, permite una aceleración de GPU sin interrupciones sin curvas de aprendizaje pronunciadas.
Los ingenieros pueden integrar GPU en sus sistemas de prueba mediante módulos RADX PXI Express (PXIe), expansión MXI Express (MXIe) o servidores de GPU en red, lo que aumenta drásticamente la velocidad de prueba y la escalabilidad del sistema. Con herramientas intuitivas y opciones de despliegue flexibles, la aceleración de la GPU ahora es accesible dentro de la plataforma NI, lo que en última instancia potencia flujos de trabajo de prueba más rápidos, escalables y listos para el futuro.
Contenido
- ¿Por qué la aceleración del hardware es esencial para los sistemas de prueba modernos?
- ¿Cómo se comparan las GPU con las FPGA y CPU para aplicaciones de prueba y medición?
- Aceleración de GPU en LabVIEW con kits de herramientas de terceros
- Conexión de una GPU al hardware NI
- Plataformas de hardware de RADX y NI
- Resumen y conclusiones clave
¿Por qué la aceleración del hardware es esencial para los sistemas de prueba modernos?
Este informe técnico explora el uso estratégico de las GPU como aceleradores de hardware para manejar las crecientes demandas de aplicaciones de prueba computacionalmente intensivas. A medida que las industrias dependen más del procesamiento de alto rendimiento para mejorar la eficiencia de las pruebas, la computación escalable y de alto rendimiento se vuelve esencial. Las GPU, con su paralelismo masivo y miles de núcleos, ofrecen una ventaja significativa sobre las CPU tradicionales, lo que las hace ideales para tareas como procesamiento de imágenes y señales, inferencia de aprendizaje profundo y cálculos de matrices.
Al integrar las GPU con NI LabVIEW y utilizar hardware y toolkits compatibles, la aceleración por GPU puede adoptarse eficazmente e integrarse sin inconvenientes en los sistemas de prueba existentes. Este enfoque facilita un marco intuitivo para ingenieros y arquitectos de sistemas para maximizar la aceleración de hardware en sus flujos de trabajo. La selección de la plataforma de hardware adecuada proporciona beneficios como una mayor velocidad de procesamiento, una latencia reducida, una mayor eficiencia energética y un rendimiento escalable para futuras aplicaciones.
¿Cómo se comparan las GPU con las FPGA y CPU para aplicaciones de prueba y medición?
Las GPU se destacan en tareas que involucran redes neuronales, procesamiento de imágenes y simulaciones debido a sus incomparables capacidades de procesamiento paralelo. Sin embargo, los beneficios del paralelismo de GPU se hacen evidentes solo a gran escala porque descargar tareas a las GPU implica costosas transferencias de datos, sincronización para la consistencia de los datos y retrasos en el lanzamiento del kernel. Las GPU no son adecuadas para conjuntos de datos pequeños caracterizados por un bajo volumen de datos y una alta varianza en las operaciones computacionales.
Las FPGA proporcionan una arquitectura personalizable ideal para sistemas deterministas como sistemas integrados y procesamiento de señales en tiempo real. Ofrecen entornos de procesamiento optimizados y soluciones de baja potencia, cruciales para los modelos de IA con limitaciones de potencia. Sin embargo, la programación de las FPGA para un rendimiento óptimo implica gastos generales significativos.
Los procesadores de propósito general suelen tener un número menor de núcleos computacionales, y cada núcleo tiene su propia unidad de control asociada, lo que permite flexibilidad y control. Las CPU tienen un mayor énfasis en las unidades de control en comparación con las GPU, que pueden permitir la conmutación de contexto de núcleo único.
Las plataformas modulares NI utilizan CPU para flexibilidad y lógica de control compleja y FPGA para determinismo y control preciso. Y ahora, agregar GPU trae un tercer pilar de aceleración orientada al rendimiento.
Aceleración de GPU en LabVIEW con kits de herramientas de terceros
LabVIEW ofrece potentes capacidades nativas y una amplia gama de funcionalidades incorporadas para diversas aplicaciones; esto se mejora aún más mediante kits de herramientas de terceros que permiten una fácil integración de la aceleración de la GPU. Estos kits de herramientas son intuitivos y se asemejan a LabVIEW nativo, reduciendo la curva de aprendizaje para los desarrolladores. Agregan funciones especializadas para el uso de la GPU, lo que ayuda a los usuarios a aprovechar la energía de la GPU sin tener que desarrollar todos los componentes desde cero. En esta sección se discutirán tres conjuntos de herramientas de terceros significativos en el ecosistema de NI que facilitan la aceleración de la GPU para varias aplicaciones, centrándose en sus características y arquitecturas efectivas para cumplir con los altos estándares de rendimiento.
El kit de herramientas Ngene CuLab
La ingeniería moderna y las aplicaciones científicas requieren una potencia computacional significativa, particularmente en áreas como el procesamiento de señales de RF, monitoreo y análisis en tiempo real, computación y modelado científico y visión artificial industrial. Si bien las GPU son ideales para estas tareas debido a su paralelismo, LabVIEW ha carecido de soporte nativo de aceleración de GPU, lo que supone un desafío para los ingenieros que no están familiarizados con CUDA o C++.
El conjunto de herramientas Ngene CuLab aborda esta laguna ofreciendo una solución de aceleración de GPU de alto rendimiento integrada directamente con LabVIEW. Cuenta con una API similar a LabVIEW, lo que permite a los ingenieros acelerar los cálculos sin codificación compleja. CuLab simplifica la integración, ofrece funciones completas aceleradas por GPU y exhibe un rendimiento superior, con un promedio 6 veces más rápido que los frameworks Python como CuPy.
CuLab ofrece varios beneficios clave. Se integra perfectamente con una API similar a LabVIEW y proporciona una mejora de más de 100 veces1 para las tareas de procesamiento de datos, en comparación con LabVIEW base en una CPU. La plataforma incluye más de 150 funciones aceleradas por GPU para manejar eficientemente matrices multidimensionales y todos los tipos de datos numéricos.
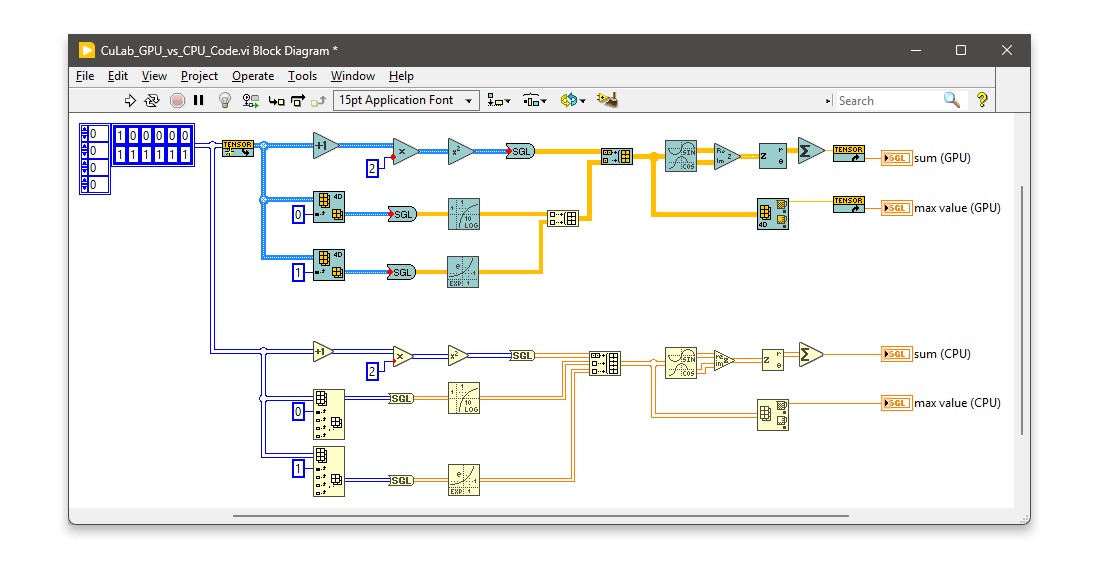
Figura 1. Este programa muestra la similitud entre las implementaciones nativas LabVIEW y CuLab.
La funcionalidad de CuLab es extensa e imita LabVIEW nativo. La lista completa de funciones incluye operaciones vectoriales y matriciales, álgebra lineal, procesamiento de señales, visión artificial, funciones matemáticas y operaciones lógicas.
El kit de herramientas SOTA gráfico
El ecosistema SOTA para LabVIEW de Graiphic introduce capacidades de aceleración de GPU enriquecidas como alternativa a marcos de aprendizaje profundo como PyTorch y TensorFlow. Transforma LabVIEW en un editor y orquestador de gráficos universal con soporte ONNX ampliado para entrenamiento y computación a través de hardware diverso. Ofreciendo abstracciones tanto de alto nivel como de bajo nivel, atiende a ingenieros que necesitan un despliegue sencillo e investigadores que buscan un control detallado, abordando un amplio espectro de necesidades de aprendizaje profundo.

Figura 2. La paleta de aceleradores tiene como objetivo cubrir completamente las operaciones estándar LabVIEW. Gestiona eficazmente la orquestación dinámica y proporciona una excelente flexibilidad para soportar diferentes proveedores de ejecución. Una referencia pública mapea la cobertura del nodo a través de múltiples backends.
SOTA rivaliza con los frameworks existentes con un completo conjunto de características, generalizadas por su kit de herramientas Accelerator que amplía la paleta de funciones LabVIEW para orquestar gráficos computacionales a través de ONNX.
Los componentes clave del ecosistema SOTA incluyen el kit de herramientas de aprendizaje profundo para capacitación e inferencia, el kit de herramientas de visión artificial para procesamiento de imágenes, el kit de herramientas GenAI para modelos basados en transformadores y el kit de herramientas aceleradoras mencionado anteriormente. Los kits de herramientas de este entorno sobresalen en visión artificial, aprendizaje profundo, GenAI y aprendizaje de refuerzo, con una integración ONNX perfecta que optimiza el rendimiento en todas las plataformas de hardware. Democratiza el desarrollo de la IA a través de la programación de flujos de datos visuales, permitiendo a los usuarios sin habilidades de programación crear flujos de trabajo complejos.
SOTA optimiza el etiquetado de datos, el entrenamiento de modelos de IA, el ajuste y la implementación en hardware heterogéneo.
Natan Biesmans LabVIEW G²CPU Kit de herramientas de cómputo de alto rendimiento
G²CPU ofrece un conjunto de herramientas informáticas de alto rendimiento para LabVIEW, que permite la ejecución de códigos adaptados a las plataformas en CPU, GPU NVIDIA CUDA, dispositivos OpenCL y todo el ecosistema NI. Construido sobre la biblioteca de código abierto ArrayFire, simplifica la conmutación de backend para una estabilidad a largo plazo.
Beneficios clave
- Abstracción de backend unificada: escriba código una vez y desplácelo en CPU, CUDA y OpenCL sin modificaciones, mejorando la flexibilidad. Este kit de herramientas se puede utilizar en todo el ecosistema de NI, que incluye dispositivos como Windows y Linux, LabVIEW Real Time Module, PXI y computadoras industriales.
- Integración perfecta: las funciones reflejan las operaciones nativas LabVIEW, facilitando la incorporación con una curva de aprendizaje mínima. La depuración es compatible con sondas que pueden inspeccionar datos a través de diferentes backends informáticos directamente dentro del entorno LabVIEW.
- Alta flexibilidad de código: implemente incluso los algoritmos más complejos en las GPU mientras permanece en el IDE nativo LabVIEW.
- Alto rendimiento: mejora la velocidad hasta 200 veces2 para tareas intensivas, con velocidades de E/S de GPU a 7 GB/s en NI PXI y más de 22 GB/s en sistemas modernos. Soporta bucles sub-1 ms en el NI LabVIEW Real-Time Module para aplicaciones sensibles al tiempo.

Figura 3. Este programa muestra un algoritmo de ajuste lineal completamente escrito en G²CPU. Note la similitud con LabVIEW nativo.
El paquete de herramientas de software ofrece un conjunto completo de funciones de alta potencia para varias tareas, incluidas matemáticas, procesamiento de señales, visión artificial, aceleración de interfaz de usuario y muchas más, todas las cuales se pueden usar en cualquier tipo de GPU y sistema operativo. Cuenta con capacidades de transferencia de datos de alta velocidad, lo que permite una integración perfecta con dispositivos como el NI PXI Vector Signal Transceiver (VST), hardware habilitado para NI FPGA y capturadores de fotogramas NI, junto con muchos otros. G²CPU es un kit de herramientas altamente flexible y eficiente que se puede ampliar con núcleos de GPU personalizados y kits de herramientas de terceros, lo que permite una integración perfecta con kits de herramientas como NVENC, LibTorch, OpenCV y muchos más. G²CPU es una solución ideal para desarrolladores que requieren un rendimiento excepcional con desarrollo sin ataduras en cualquier dominio.
Conexión de una GPU al hardware NI
Esta sección cubre la conexión a un servidor GPU, así como las configuraciones de PXI Express a MXI Express.
Conexión de red al servidor GPU
La conexión a un servidor de GPU se puede lograr de manera eficiente a través de tarjetas de interfaz de red (NIC) y NIC inteligentes, que ofrecen capacidades avanzadas para optimizar el rendimiento de la red. Las NIC inteligentes integran componentes de CPU y GPU para soportar exigentes tareas de procesamiento computacional y paralelo. Descargan inteligentemente el procesamiento de red para reducir la sobrecarga, mejorando la eficiencia del flujo de datos al servidor de la GPU. Las NIC inteligentes pueden mejorar el manejo de datos a través de redes, soportando aplicaciones informáticas distribuidas con un ancho de banda de hasta 25 GB/s para un uso más efectivo de los recursos de la GPU en red. Otros hardware de NI, incluyendo los sistemas NI CompactRIO y NI CompactDAQ, pueden usar conexiones de red Ethernet o USB para interactuar y usar también los recursos del servidor de la GPU.

Figura 4. Un chasis PXI está conectado en red a un servidor de GPU externo para computación acelerada y de alta velocidad a través de NIC o NIC inteligente.
PXI Express a MXI Express
Las configuraciones PXIe a MXIe son beneficiosas para configuraciones que necesitan capacidades de GPU externas, especialmente en computación de alto rendimiento. Al conectar el chasis PXIe con las interfaces MXIe, los usuarios pueden acceder a potentes GPU externas, mejorando la capacidad computacional más allá de los límites de hardware locales. Esta configuración es ideal para espacios y escenarios restringidos que requieren múltiples GPU en todos los sistemas para tareas como procesamiento de datos a gran escala, desarrollo de IA o simulaciones. La interfaz Gen 3 x16 MXIe admite velocidades de transferencia de datos de 16 GB/s, lo que reduce los cuellos de botella y permite a las aplicaciones exigentes utilizar eficientemente los recursos externos de la GPU o del servidor de la GPU.

Figura 5. Un chasis PXIe se conecta a un servidor GPU a través de la expansión MXIe, lo que permite la transferencia de datos de alto ancho de banda para un procesamiento acelerado y un cálculo avanzado.
Plataformas de hardware de RADX y NI
RADX Technologies Inc. ofrece módulos de GPU PXI Express comerciales listos para usar (COTS) diseñados para el ecosistema de NI, pero distintos de las ofertas de NI. Basados en las GPU NVIDIA Turing, Ampere y Ada, estos módulos se integran perfectamente en el chasis PXI Express, como el NI PXIe-1092 o el NI PXIe-1095, mejorando la potencia informática para entornos de prueba y medición. Las GPU RADX PXIe admiten numerosas aplicaciones, como la adquisición de datos y el aprendizaje automático, utilizando herramientas como LabVIEW y Python, sin necesidad de servidores de GPU separados.
Las GPU integradas de RADX Technologies ofrecen TFLOPS FP32 de 1,7 a 30,3 con memoria de 4 GB a 24 GB. Sin embargo, estas configuraciones pueden enfrentar cuellos de botella de datos causados por la falta de comunicación entre GPU, excepto cuando se usa Linux. Se requieren técnicas como la copia cero para mitigar estas limitaciones y aprovechar al máximo las capacidades de la GPU y aliviar esos cuellos de botella. Las GPU RADX están calificadas para sistemas NI y a menudo se emparejan con G²CPU para el procesamiento de señales LabVIEW acelerado por GPU.

Figura 6. Módulos y ofertas de GPU compatibles con RADX PXIe
Resumen y conclusiones clave
En conclusión, las GPU son adoptadas cada vez más por los ingenieros de pruebas para pruebas más rápidas debido a su excepcional rendimiento y programabilidad. Su paralelismo masivo y su potencia computacional escalable los hacen ideales para aplicaciones de gran densidad de datos como procesamiento de señales, procesamiento de imágenes, simulaciones y control basado en modelos. Sin embargo, debido a sus demandas de datos, las GPU siguen siendo una adición de nicho para flujos de trabajo adecuados.
La integración de la aceleración de la GPU en el ecosistema NI, utilizando GPU asociadas compatibles con PXI Express y kits de herramientas LabVIEW, democratiza el uso de la GPU para los ingenieros de pruebas al proporcionar un complemento flexible y de alto rendimiento a los flujos de trabajo existentes. Esta integración dentro de entornos familiares reduce la barrera de entrada, permitiendo un prototipo más rápido, un rendimiento de datos eficiente y una mejor escalabilidad del sistema.
Comprender cómo utilizar eficazmente las GPU ofrece a las organizaciones de pruebas y mediciones una ventaja competitiva en el diseño de sistemas que estén preparados para el futuro. Reconocer las ganancias de rendimiento de la GPU, aprovechar las herramientas apropiadas e identificar tareas computacionalmente intensivas son pasos clave.
1 Vea una demo grabada que muestra cómo CuLab (GPU Toolkit for LabVIEW) acelera las aplicaciones de RF RTSA.
2 Para más información, visite g2cpu.com.
| Dominio de aplicación | Donde ganan las GPU |
|---|---|
| Grabación y reproducción de RF/análisis de espectro | FFTs de varios gigahercios en tiempo real, canalizadores polifásicos y representación de espectrogramas |
| Visión de alta velocidad/inspección basada en imágenes | Las redes neuronales convolucionales (CNN) y los filtros OpenCV clásicos ejecutan cientos de fotogramas por segundo |
| Análisis masivo de forma de onda | Procesamiento por lotes de millones de formas de onda con filtros, correlaciones o detección de anomalías de aprendizaje profundo |
Cuadro 1 Aprovechamiento de la potencia de las GPU para tareas en dominios de aplicaciones clave
| Características | CPU | FPGA | GPU |
|---|---|---|---|
| Mejor para | Lógica secuencial y pesada en ramas; servicios de SO, cargas de trabajo de IA/ML más pequeñas (rango de cientos de GFLOP) | Latencia de nanosegundo nivel; protocolos de E/S personalizados | Matemáticas paralelas a escala teraflop/petaflop; cargas de trabajo IA/ML |
| Determinismo | Fluctuación de 10 μs-ms (SO preventivo) | Ejecución precisa del ciclo; temporización determinista a nivel de hardware | Moderada fluctuación; ejecución determinista dentro de los núcleos lanzados |
| Flujo de desarrollo | C/C++, LabVIEW RT, Python | LabVIEW FPGA, VHDL/Verilog, HLS | CUDA/HIP, LabVIEW GPU Toolkits, Python (Numba/CuPy) |
| Costo objetivo | Ninguno | Alto (síntesis, cierre de tiempos) | Baja (recompilar kernel en segundos) |
| Uso típico en pruebas y mediciones | Secuenciación, interfaz de usuario del host, registro de datos | Momento preciso, activación personalizada, filtrado en línea | FFTs, espectrogramas, inferencia de aprendizaje profundo, operaciones de matriz grande |
Tabla 2. Elegir el motor correcto: CPU, GPU o FPGA?
Próximos pasos
- Descubra el LabVIEW G²CPU High-Performance Compute Toolkit en la red de herramientas NI
- Obtenga el Ngene CuLab - GPU Accelerated Toolkit en la Red de Herramientas NI
- Explora y descarga el kit de herramientas SOTA en el sitio web de Graiphic
- Visite el sitio web de RADX Technologies Inc. para obtener más detalles y ofertas
- Más información sobre Ngene Toolkits visitando su sitio web
- Obtenga más información sobre el kit de herramientas G²CPU visitando su sitio web
Windows es una marca comercial del grupo de empresas Microsoft. La marca comercial registrada Linux® se utiliza conforme a una sublicencia otorgada por LMI, el licenciatario exclusivo de Linus Torvalds, propietario de la marca en todo el mundo.