ASAMice sus datos de medición
Contenido
Cuando se habla de datos de medición, el enfoque principal suele estar en los datos almacenados en archivos. Esos archivos son producidos por una variedad de sistemas de medición que almacenan la información en diferentes formatos. Los diferentes formatos de archivo varían desde simples archivos de valores separados por comas (CSV) hasta formatos binarios específicos adaptados a necesidades particulares (hardware de medición), desde documentos XML estructurados hasta volcados binarios de canales, o combinaciones y variaciones de los anteriores. Cada formato de archivo sirve para un propósito específico, como facilitar el intercambio de datos con herramientas de hojas de cálculo (CSV) o la transmisión de datos a alta velocidad (TDMS); sin embargo, la falta de estándares adecuados para casos de uso específicos genera la necesidad de formatos de archivo personalizados.
La multiplicidad de formatos de archivo presenta un desafío cuando se requieren herramientas de análisis de datos, generación de informes, visualización u otras similares para procesar los archivos y almacenarlos en diferentes formatos que permitan el intercambio de datos entre productos. Considerando X formatos de archivo y herramientas, la complejidad del problema es del orden de X por Y, lo que significa que más formatos o herramientas conllevan un crecimiento exponencial del esfuerzo. La variedad de formatos, la velocidad a la que se adquieren y almacenan los datos, y el volumen resultante han sido identificados por NI como el problema de Big Analog DataTM.
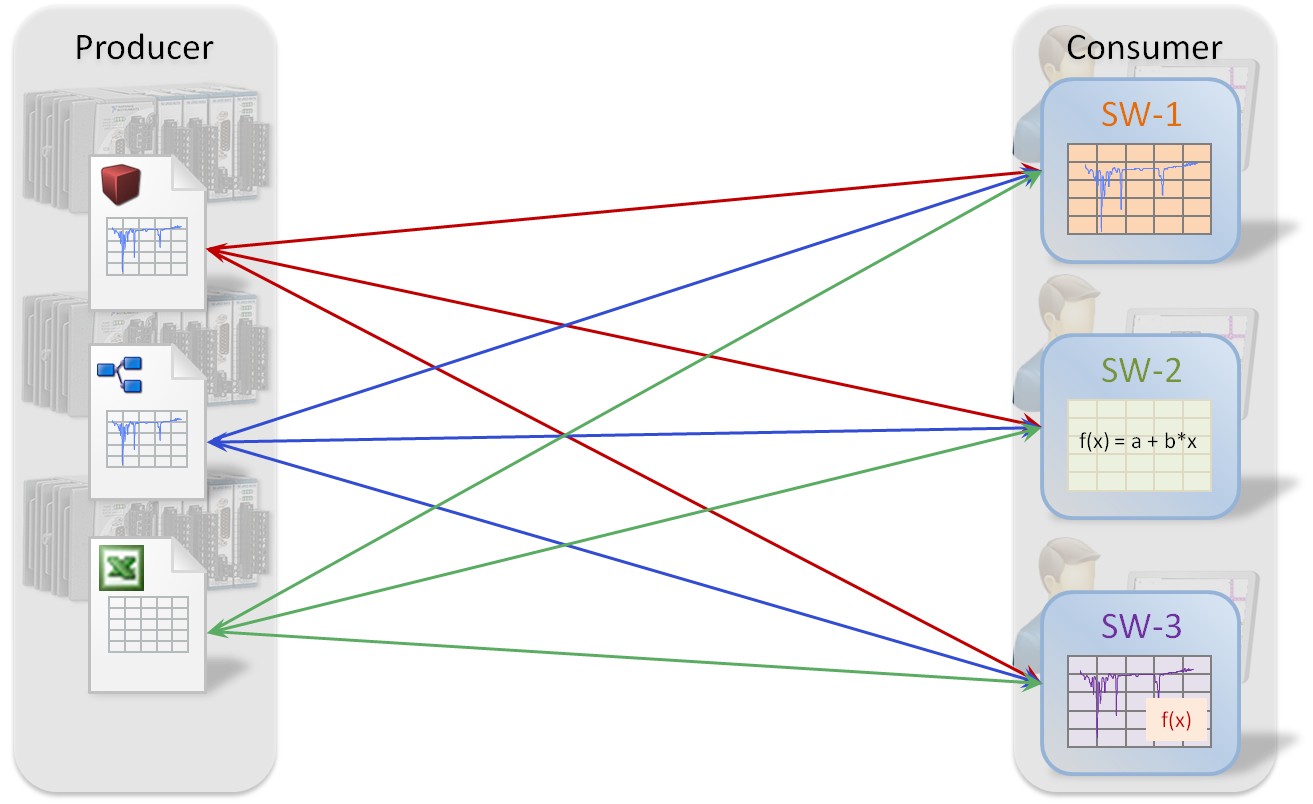
Figura 1: Los formatos de archivo X y las herramientas de lectura Y aumentan la complejidad del análisis y reporte de datos.
La clave para resolver este problema es reducir los grados de libertad manteniendo viva la cadena de herramientas. Parece poco probable que la variedad de formatos de archivo desaparezca. Siempre habrá un productor de datos específico con necesidades particulares que no pueden ser satisfechas por un formato de archivo estándar. Por lo tanto, en lugar de obligar a todos los productores de datos a escribir en el mismo formato, la solución deseable es introducir un formato de datos intermedio (o modelo de datos) capaz de alojar el contenido de los X diferentes formatos. O, en otras palabras, un formato al que todos los demás formatos de datos puedan mapearse o convertirse.
Usar una interfaz estándar de programación de aplicaciones (API) para leer los datos intermedios reduce la complejidad del sistema al orden de X+1, especialmente porque muchos consumidores de datos ya han implementado la API.
Con una tecnología común para mapear archivos de datos de medición a un modelo intermedio, nace una solución Big Analog Data TM que puede ayudar a aumentar la visibilidad y el valor.
NI ha introducido esta solución ofreciendo la tecnología DataPlugin para mapear archivos de medición a un modelo adecuado: TDM. La indexación de esos archivos mediante el SystemLink TDM DataFinder Module permite recuperar los archivos mediante búsqueda paramétrica y de texto completo, y que los datos indexados sean accesibles a través de una interfaz estándar: ASAM ODS.
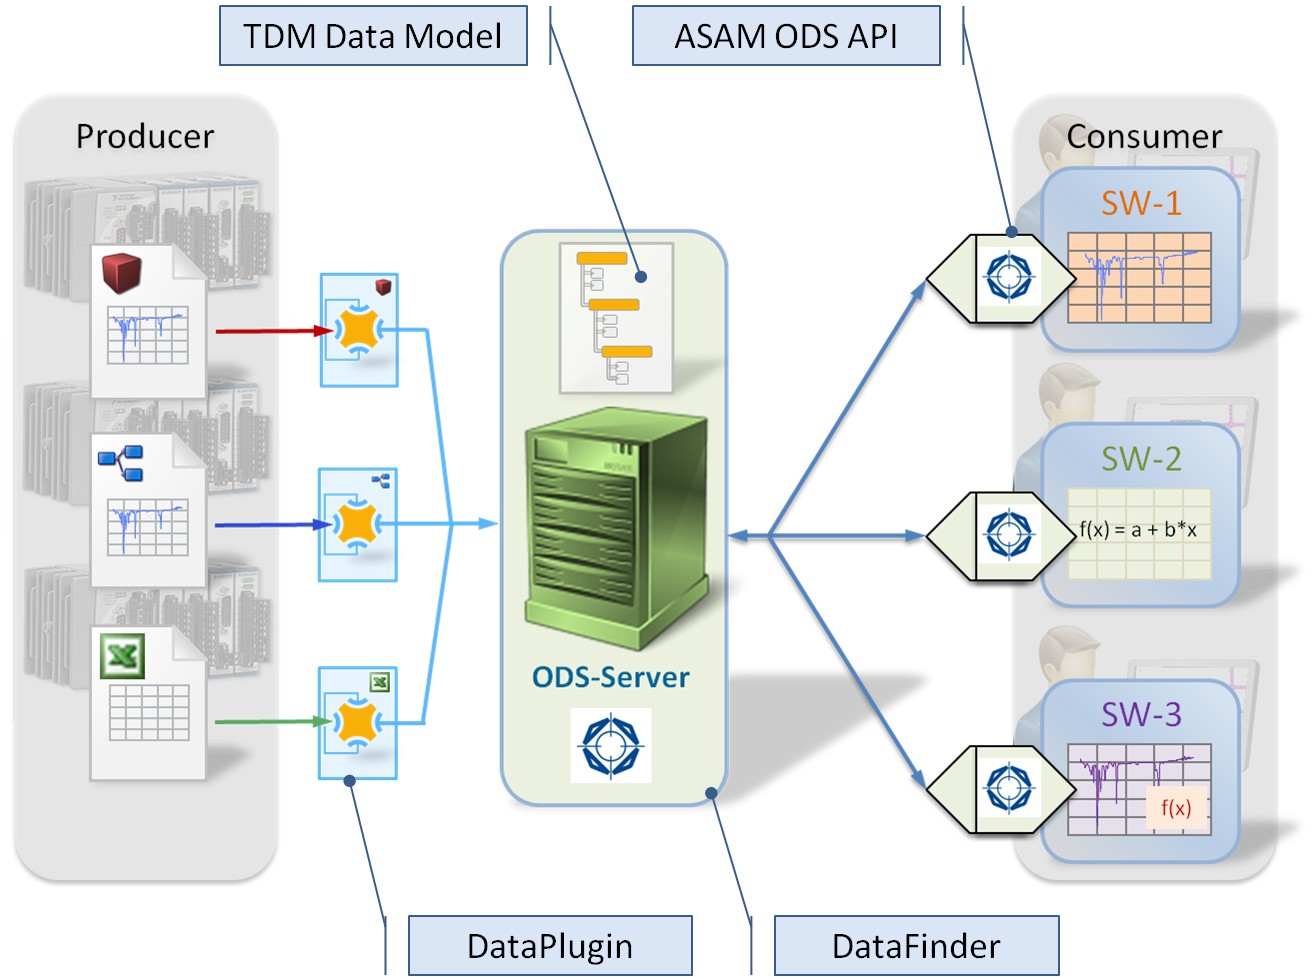
Figura 2: Cualquier formato de archivo puede mapearse al modelo TDM mediante una tecnología llamada DataPlugins, que permite usar una sola herramienta para acceder y analizar diversas fuentes de datos.
Exploremos más la solución ofrecida revisando sus diferentes componentes:
Modelo de datos TDM
El modelo de datos TDM es un modelo simple pero adecuado y flexible para datos de medición. Se deriva del modelo base ASAM ODS, enfocándose en minimizar la complejidad.
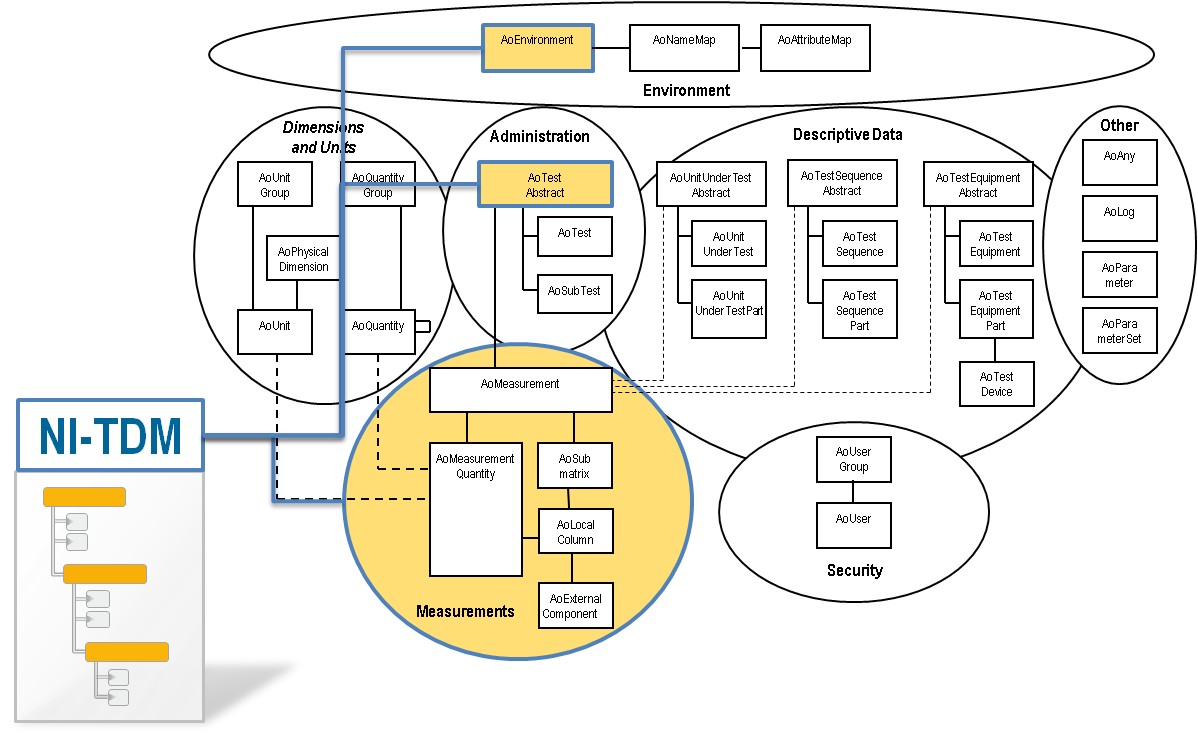
Figura 3: Una representación del modelo base ASAM ODS completo y los tres niveles en los que se centra el modelo TDM para minimizar la complejidad.
La jerarquía de tres niveles del modelo TDM permite organizar sus canales en grupos y luego agrupar esos grupos bajo una única raíz. En cada uno de los tres niveles puede almacenar un número ilimitado de propiedades personalizadas. Puede obtener más información sobre los beneficios del modelo TDM y la estructura interna.
DataPlugins
Un DataPlugin es la descripción programática de cómo mapear cualquier formato de archivo personalizado al modelo de datos TDM. La mayoría de los DataPlugins están escritos en VBScript debido a las API existentes para acceder a archivos de texto, binarios o de hoja de cálculo, pero también existen API para C++ o LabVIEW. NI DIAdem también ofrece asistentes para crear sus propios DataPlugins. Antes de comenzar a escribir su propio DataPlugin, consulte ni.com/dataplugins para saber si ya existe un DataPlugin para su formato específico y está disponible para descarga gratuita.
ASAM ODS
ASAM significa “Asociación para la estandarización de sistemas de automatización y medición” y ODS significa “Servicios de datos abiertos”.
ASAM ODS es un estándar internacional de la industria automotriz para almacenar datos de medición. National Instruments, como cofundador de ASAM y miembro activo del grupo de trabajo de ASAM ODS, ha introducido el estándar ASAM ODS incluso fuera del sector automotriz en la industria de la medición. ASAM ODS define el almacenamiento de datos, por ejemplo, en un servidor Oracle o de modo mixto y una API basada en Corba para el acceso a datos. El principal beneficio es la especificación de un denominado modelo de datos base que añade información semántica (meta) a los datos.
El modelo de datos TDM se deriva del modelo base ASAM ODS. En el contexto de ASAM ODS, el modelo de datos TDM+ ofrece además una jerarquía personalizada de profundidad arbitraria derivada de los metadatos existentes y un catálogo de unidades extensible, manteniendo sin cambios el modelo TDM y los archivos de medición.
Tanto la API Corba como el modelo TDM+ forman parte de DataFinder Server Edition.
DataFinder
NI SystemLink TDM DataFinder Module es un software centralizado de gestión de datos para manejar grandes cantidades de datos generados durante pruebas y simulación. El SystemLink TDM DataFinder Module funciona de inmediato indexando archivos de prueba en un servidor o red sin necesidad de soporte de TI o conocimientos de bases de datos. El índice de datos se construye y escala automáticamente a medida que cambian sus archivos de prueba.
DataFinder permite acceder a los datos indexados mediante los archivos originales usando DIAdem o LabVIEW DataFinder Toolkit, o mediante una API ASAM ODS Corba.
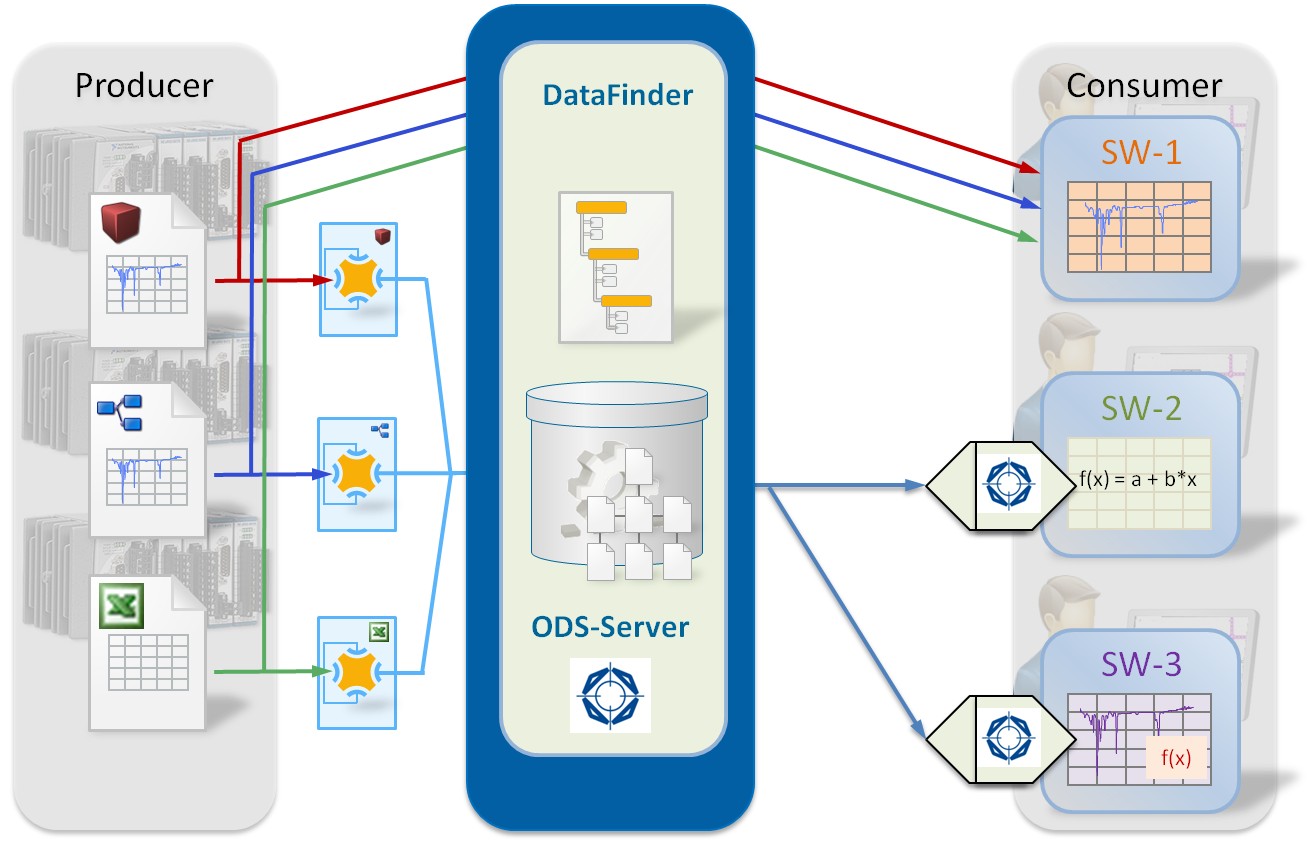
Figura 4: Al proporcionar una interfaz basada en archivos y otra ASAM ODS, DataFinder se integra fácilmente en procesos existentes y aporta valor y visibilidad a los datos.